MTH303 专题补充讲义
Deviance、KL 散度与似然比
从 Neyman–Pearson 到 GLM:历史与推导
这几个概念经常在同一页出现,却不是同一层次的对象。
本讲义从“怎样比较两个模型对数据的解释”出发,逐步连接检验、信息量和 GLM
拟合优度。 全部对数使用自然对数,信息量单位为 nat。
先记住四句话,再看证明
似然比 比较两个分布对同一份数据给出的相对密度或概率。
Neyman–Pearson
引理 说明:简单原假设对简单备择时,按似然比排序可以在给定第一类错误率下最大化功效。
KL
散度 是取定期望分布之后的平均对数似然比。
Deviance 在 GLM
中将拟合模型与饱和模型的最大化似然作比较;它可以在明确条件下写成 KL
散度之和。
log f 1 ( Y ) f 0 ( Y ) ⏟ 随机的相对证据 → 𝔼 1 D K L ( P 1 ‖ P 0 ) ⏟ 平均信息差异 \underbrace{\log\frac{f_1(Y)}{f_0(Y)}}_{\text{随机的相对证据}}
\quad\xrightarrow{\ \mathbb E_1\ }\quad
\underbrace{D_{\mathrm{KL}}(P_1\Vert P_0)}_{\text{平均信息差异}} 2 ( ℓ f u l l − ℓ n u l l ) ⏟ 广义似然比统计量 → f u l l = s a t u r a t e d D * ⏟ scaled deviance . \underbrace{2(\ell_{\mathrm{full}}-\ell_{\mathrm{null}})}_{\text{广义似然比统计量}}
\quad\xrightarrow{\ \mathrm{full}=\mathrm{saturated}\ }\quad
\underbrace{D^*}_{\text{scaled deviance}}.
读完应能回答的问题
为什么 KL 的两个分布不能交换?为什么似然比要取对数、再乘 2? 为什么
deviance 有时等于
2 n K L 2n\,\mathrm{KL}
本讲义的约定
用
r = f 1 / f 0 r=f_1/f_0 Λ = sup Θ 0 L / sup Θ 1 L ≤ 1 \Lambda=\sup_{\Theta_0}L/\sup_{\Theta_1}L\le1 a > 0 a>0 D = a D * D=aD^*
教学顺序与历史顺序不同 可以用 KL
统一解释早期的似然比检验,但这不表示历史上先有 KL,再由它发明检验。
后文按原始论文年代梳理:似然理论、检验最优性、大样本分布、信息论和
GLM。
Likelihood
ratio:固定数据,比较两个解释
概率与似然使用同一个公式,固定的对象不同
设观测数据为
y y f ( y ; θ ) f(y;\theta) θ \theta Y Y y y θ \theta L ( θ ; y ) = f ( y ; θ ) . L(\theta;y)=f(y;\theta). f ( y ; θ ) f(y;\theta) Y = y Y=y
从两个完全指定的假设开始
考虑
H 0 : Y ∼ P 0 H_0:Y\sim P_0 H 1 : Y ∼ P 1 H_1:Y\sim P_1 f 0 , f 1 f_0,f_1 r ( y ) = f 1 ( y ) f 0 ( y ) , s ( y ) = log r ( y ) = log f 1 ( y ) − log f 0 ( y ) . {r(y)=\frac{f_1(y)}{f_0(y)}},\qquad
{s(y)=\log r(y)=\log f_1(y)-\log f_0(y)}. r ( y ) > 1 r(y)>1 P 1 P_1 r ( y ) < 1 r(y)<1 f 0 = 0 , f 1 > 0 f_0=0,f_1>0 + ∞ +\infty
独立观测使证据相乘,对数证据相加
若
Y 1 , … , Y n Y_1,\ldots,Y_n p 0 , p 1 p_0,p_1 r n ( y 1 , … , y n ) = ∏ i = 1 n p 1 ( y i ) p 0 ( y i ) , log r n = ∑ i = 1 n log p 1 ( y i ) p 0 ( y i ) . r_n(y_1,\ldots,y_n)=\prod_{i=1}^n\frac{p_1(y_i)}{p_0(y_i)},
\qquad
\log r_n=\sum_{i=1}^n\log\frac{p_1(y_i)}{p_0(y_i)}. 对数似然比的平均值 。
本讲义保留两种方向,避免负号混乱
简单检验用
r = f 1 / f 0 r=f_1/f_0 ,
r r
大时拒绝
H 0 H_0 。
复合假设的广义似然比将用
Λ = sup H 0 L / sup f u l l L \Lambda=\sup_{H_0}L/\sup_{\mathrm{full}}L ,
Λ \Lambda
小时拒绝。这两个符号的分子方向不同,后文会明确换算。
Neyman–Pearson:先控制误报,再提高检出率
把检验写成一个函数
令
φ ( y ) ∈ [ 0 , 1 ] \varphi(y)\in[0,1] y y H 0 H_0 0 , 1 0,1 0 < φ ( y ) < 1 0<\varphi(y)<1 𝔼 0 { φ ( Y ) } ⏟ size:原假设为真时误拒的概率 , 𝔼 1 { φ ( Y ) } ⏟ power:指定备择下拒绝的概率 . \underbrace{\mathbb E_0\{\varphi(Y)\}}_{\text{size:原假设为真时误拒的概率}},
\qquad
\underbrace{\mathbb E_1\{\varphi(Y)\}}_{\text{power:指定备择下拒绝的概率}}. 1 − 𝔼 1 φ 1-\mathbb E_1\varphi max 0 ≤ φ ≤ 1 𝔼 1 φ 满足 𝔼 0 φ ≤ α . {\max_{0\le\varphi\le1}\ \mathbb E_1\varphi
\quad\text{满足}\quad \mathbb E_0\varphi\le\alpha.} P 1 P_1
Neyman–Pearson
引理给出的最优规则
选取阈值
c ≥ 0 c\ge0 γ ∈ [ 0 , 1 ] \gamma\in[0,1] φ * ( y ) = { 1 , r ( y ) > c , γ , r ( y ) = c , 0 , r ( y ) < c , 𝔼 0 φ * = α . \varphi_*(y)=
\begin{cases}
1,&r(y)>c,\\
\gamma,&r(y)=c,\\
0,&r(y)<c,
\end{cases}
\qquad \mathbb E_0\varphi_* =\alpha. φ * \varphi_* α \alpha P 1 P_1 最强力检验 (most powerful)。
为什么直觉上应该按似然比排序?
把一个很小的区域纳入拒绝域,获得的检出概率约为
f 1 ( y ) d y f_1(y)\,dy f 0 ( y ) d y f_0(y)\,dy r ( y ) r(y)
精确最优性有明确范围
这是简单原假设对简单备择的有限样本结论,不需要大样本或卡方近似。
它不自动说明一个检验对所有备择都同时最优;也不把“拒绝”解释为原假设的后验概率很小。
Neyman–Pearson
引理的完整不等式证明
取任意另一个检验
φ \varphi 𝔼 0 φ ≤ α \mathbb E_0\varphi\le\alpha 𝔼 1 φ * ≥ 𝔼 1 φ \mathbb E_1\varphi_*\ge\mathbb E_1\varphi
第 1
步:检查每一个数据点处的符号
若
f 1 − c f 0 > 0 f_1-cf_0>0 φ * = 1 \varphi_*=1 φ * − φ ≥ 0 \varphi_*-\varphi\ge0
若
f 1 − c f 0 < 0 f_1-cf_0<0 φ * = 0 \varphi_*=0 φ * − φ ≤ 0 \varphi_*-\varphi\le0
若
f 1 − c f 0 = 0 f_1-cf_0=0
所以逐点有
( φ * − φ ) ( f 1 − c f 0 ) ≥ 0 . {(\varphi_* -\varphi)(f_1-cf_0)\ge0.}
第 2
步:积分,再把两种概率分开
对共同基准测度
ν \nu 0 ≤ ∫ ( φ * − φ ) ( f 1 − c f 0 ) d ν = ( 𝔼 1 φ * − 𝔼 1 φ ) − c ( 𝔼 0 φ * − 𝔼 0 φ ) . \begin{align*}
0&\le\int(\varphi_*-\varphi)(f_1-cf_0)\,d\nu\\
&=\bigl(\mathbb E_1\varphi_*-\mathbb E_1\varphi\bigr)
-c\bigl(\mathbb E_0\varphi_*-\mathbb E_0\varphi\bigr).
\end{align*} 𝔼 0 φ * = α \mathbb E_0\varphi_*=\alpha 𝔼 0 φ ≤ α \mathbb E_0\varphi\le\alpha 𝔼 1 φ * − 𝔼 1 φ ≥ c ( α − 𝔼 0 φ ) ≥ 0 . \mathbb E_1\varphi_*-\mathbb E_1\varphi
\ge c\bigl(\alpha-\mathbb E_0\varphi\bigr)\ge0.
边界随机化为什么不会破坏证明?
在
f 1 = c f 0 f_1=cf_0 c c α \alpha α \alpha
证明里真正使用了什么?
只用了似然比的排序、检验函数在
[ 0 , 1 ] [0,1]
内、以及同一误报约束。 这里没有使用 KL,也没有使用 MLE、饱和模型或 Wilks
定理; 那些联系需要在后面分别建立。
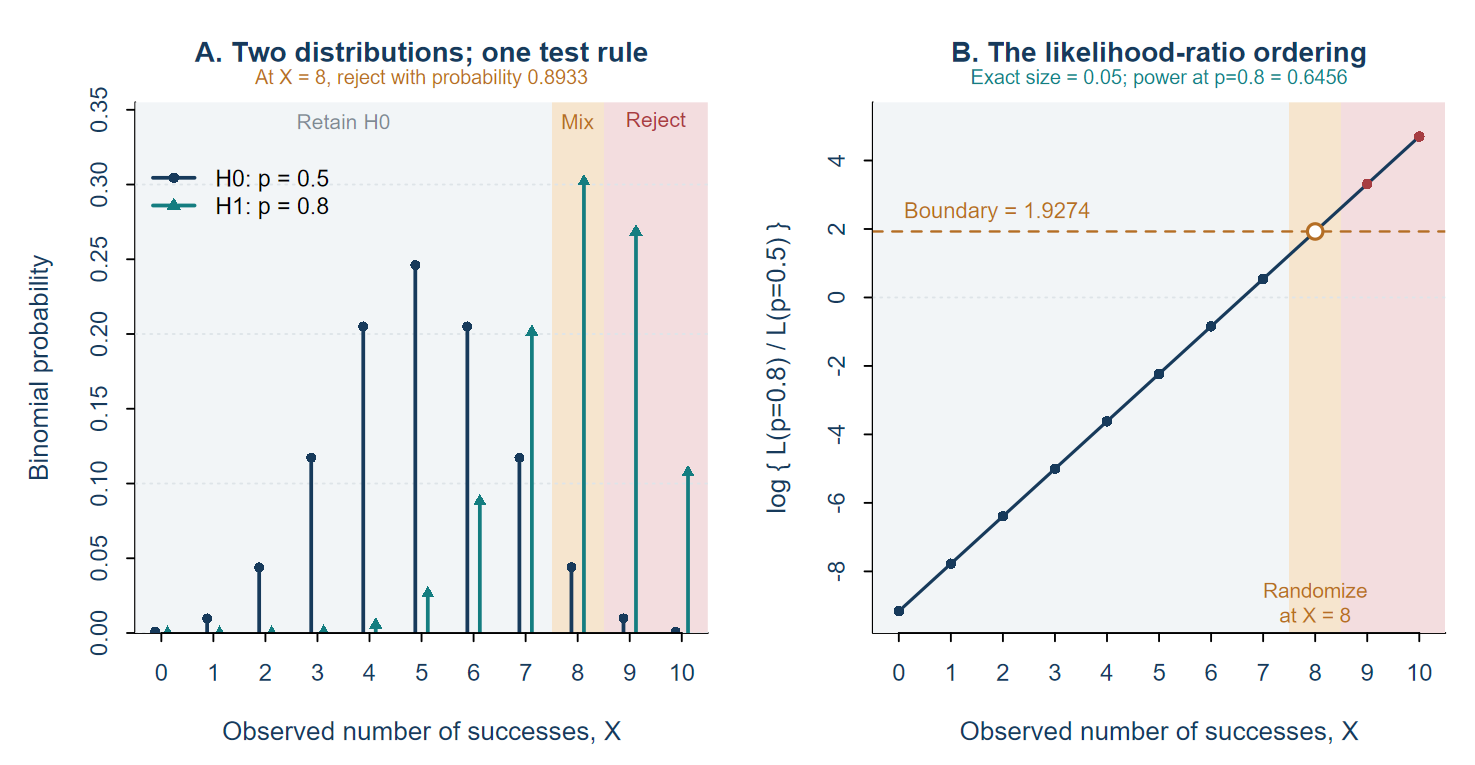
手算 NP 检验:10
次试验中观察到 8 次成功
令
S ∼ Binomial ( 10 , p ) S\sim\operatorname{Binomial}(10,p) H 0 : p = 0.5 , H 1 : p = 0.8 . H_0:p=0.5,\qquad H_1:p=0.8. r ( s ) = ( 10 s ) 0.8 s 0.2 10 − s ( 10 s ) 0.5 10 = 1.6 s 0.4 10 − s = 0.4 10 4 s . r(s)=\frac{\binom{10}{s}0.8^s0.2^{10-s}}
{\binom{10}{s}0.5^{10}}
=1.6^s0.4^{10-s}=0.4^{10}4^s. r ( s ) r(s) s s
先计算观测到的证据
当
s = 8 s=8 r ( 8 ) = 6.87194767 , log r ( 8 ) = 8 log 1.6 + 2 log 0.4 = 1.92744757 . r(8)=6.87194767,\qquad
\log r(8)=8\log1.6+2\log0.4=1.92744757. p = 0.8 p=0.8
再按
H 0 H_0
P 0 ( S ≥ 9 ) = 11 1024 = 0.01074219 , P 0 ( S = 8 ) = 45 1024 = 0.04394531 . P_0(S\ge9)=\frac{11}{1024}=0.01074219,
\quad P_0(S=8)=\frac{45}{1024}=0.04394531. P 0 ( S ≥ 8 ) = 56 / 1024 = 0.0546875 > 0.05 P_0(S\ge8)=56/1024=0.0546875>0.05 S ≥ 9 必拒; S = 8 以 γ = 67 75 的概率拒绝 . {S\ge9\text{ 必拒; }S=8\text{ 以 }\gamma=\frac{67}{75}\text{ 的概率拒绝}.} 11 1024 + γ 45 1024 = 0.05 ⇒ γ = 0.89333333 . \frac{11}{1024}+\gamma\frac{45}{1024}=0.05
\quad\Longrightarrow\quad \gamma=0.89333333. p = 0.8 p=0.8 P 1 ( S ≥ 9 ) + γ P 1 ( S = 8 ) = 0.37580964 + 67 75 ( 0.30198989 ) = 0.64558727 . P_1(S\ge9)+\gamma P_1(S=8)
=0.37580964+\frac{67}{75}(0.30198989)=0.64558727.
若不愿随机化,应如实报告实际 size 简单采用
S ≥ 9 S\ge9 S ≥ 8 S\ge8 P 0 ( S ≥ 8 ) = 0.0546875 P_0(S\ge8)=0.0546875
同一份数据:NP 单侧证据与
GLR 双侧证据
图 1:单个二项计数(n = 10)的 Neyman–Pearson 检验。固定似然比随 X 增大;H₀: p = 0.5 对 H₁: p = 0.8 时,X ≥ 9 拒绝,X = 8 处按 γ = 67/75 随机化,X ≤ 7 保留;检验水平恰为 0.05(不随机化时 X ≥ 8 的 size 为 0.0547,X ≥ 9 为 0.0107)。
简单备择
p = 0.8 p=0.8
上一页的 NP 检验比较固定的
p = 0.8 p=0.8 p = 0.5 p=0.5 p = 0.8 p=0.8
若备择是任意
p ≠ 0.5 p\ne0.5
对每个观测
s s p ̂ = s / 10 \hat p=s/10 G 2 ( s ) = 2 [ s log s / 10 0.5 + ( 10 − s ) log 1 − s / 10 0.5 ] . G^2(s)=2\left[s\log\frac{s/10}{0.5}
+(10-s)\log\frac{1-s/10}{0.5}\right]. 0 log 0 = 0 0\log0=0 s = 5 s=5 s = 8 s=8 G 2 = 3.85489514 = 2 log r ( 8 ) G^2=3.85489514=2\log r(8) 只是因为本次数据的 MLE 恰好等于预先指定的
0.8 0.8 。
相同的统计量数值,不代表相同的检验
原假设下,G 2 ( S ) ≥ G 2 ( 8 ) G^2(S)\ge G^2(8) S ≤ 2 S\le2 S ≥ 8 S\ge8 P 0 { G 2 ( S ) ≥ G 2 ( 8 ) } = 2 56 1024 = 0.109375 . P_0\{G^2(S)\ge G^2(8)\}=2\frac{56}{1024}=0.109375. χ 1 2 \chi^2_1 p ≈ 0.04960 p\approx0.04960 n = 10 n=10
先说假设,再比较统计量
NP
的简单备择决定了单侧的似然排序;GLR
的复合备择允许向两个方向寻找更好的参数。
检验不是一个孤立数字,还包括原假设、备择和原假设下的校准规则。
从简单似然比到广义似然比:增加的是优化
两个模型各自把参数拟合到最好
令
Θ 0 ⊂ Θ \Theta_0\subset\Theta H 0 : θ ∈ Θ 0 H_0:\theta\in\Theta_0 Θ \Theta Λ ( y ) = sup θ ∈ Θ 0 L ( θ ; y ) sup θ ∈ Θ L ( θ ; y ) ≤ 1 , {\Lambda(y)=\frac{\sup_{\theta\in\Theta_0}L(\theta;y)}
{\sup_{\theta\in\Theta}L(\theta;y)}\le1}, G 2 ( y ) = − 2 log Λ ( y ) = 2 { ℓ ( θ ̂ ; y ) − ℓ ( θ ̂ 0 ; y ) } ≥ 0 . {G^2(y)=-2\log\Lambda(y)
=2\{\ell(\hat\theta;y)-\ell(\hat\theta_0;y)\}\ge0.} G 2 ≥ 0 G^2\ge0
为什么写成
− 2 log Λ -2\log\Lambda
取负号使“更不支持原假设”对应更大的数;乘以 2
与后面的局部二次型展开配合,
在正则情形下产生熟悉的卡方极限。这个变换不改变
Λ \Lambda
为什么不能直接援引 NP 说 GLR
最强力?
NP 的证明比较两个固定密度
f 0 , f 1 f_0,f_1 θ ̂ \hat\theta θ ̂ 0 \hat\theta_0 y ↦ sup θ f ( y ; θ ) y\mapsto\sup_\theta f(y;\theta)
三个需要分开的结论 NP 引理给简单假设的有限样本最强力性;
GLR 给复合假设的一种一般构造; Wilks 定理在正则条件下给 GLR
的大样本零分布。 特殊模型可能有一致最强力检验,但不是任意 GLR
自动具有的性质。
下一步把完整模型换成能逐点拟合数据的饱和模型,就会得到 deviance。
再研究对数似然比的期望,就会得到 KL
散度;这是两条不同、最终相接的联系。
KL 散度:先选定谁产生数据
设
P , Q P,Q p , q p,q D K L ( P ‖ Q ) = 𝔼 P [ log p ( Y ) q ( Y ) ] = ∫ p ( y ) log p ( y ) q ( y ) d y . {D_{\mathrm{KL}}(P\Vert Q)=\mathbb E_P\!\left[\log\frac{p(Y)}{q(Y)}\right]
=\int p(y)\log\frac{p(y)}{q(y)}\,dy.} 左边的分布决定平均时的权重 :
数据由
P P Q Q P P
零概率与无穷大的约定
在离散求和中令
0 log ( 0 / q ) = 0 0\log(0/q)=0 P P Q Q D K L ( P ‖ Q ) = + ∞ D_{\mathrm{KL}}(P\Vert Q)=+\infty P ≪ Q P\ll Q P P Q Q
非负性不是定义,而是可证明的性质
在相关期望存在时,用
− log t ≥ 1 − t -\log t\ge1-t t = q ( y ) / p ( y ) t=q(y)/p(y) D K L ( P ‖ Q ) = 𝔼 P [ − log { q ( Y ) / p ( Y ) } ] ≥ 1 − ∫ { p > 0 } q ( y ) d y ≥ 0 . \begin{align*}
D_{\mathrm{KL}}(P\Vert Q)
&=\mathbb E_P[-\log\{q(Y)/p(Y)\}]\\
&\ge1-\int_{\{p>0\}}q(y)\,dy\ge0.
\end{align*} Q Q P P D K L ( P ‖ Q ) = 0 D_{\mathrm{KL}}(P\Vert Q)=0 P = Q P=Q
它为什么叫“散度”而不叫通常的距离?
KL 一般不对称,也不满足距离函数的三角不等式。
非负只能说明它衡量差异,不能让它自动具有欧氏距离的全部性质。
最直接的解释
log p ( Y ) \log p(Y)
是使用真实分布的对数得分,
log q ( Y ) \log q(Y)
是使用替代分布的对数得分。 KL
是两者在真实分布下的平均差。某一次数据可能偏向
Q Q ,但平均差不会为负。
KL
正是平均对数似然比:方向决定符号
对简单假设
P 0 P_0 P 1 P_1 r ( Y ) = f 1 ( Y ) / f 0 ( Y ) r(Y)=f_1(Y)/f_0(Y) 𝔼 1 [ log r ( Y ) ] = D K L ( P 1 ‖ P 0 ) ≥ 0 , {\mathbb E_1[\log r(Y)]=D_{\mathrm{KL}}(P_1\Vert P_0)\ge0,} 𝔼 0 [ log r ( Y ) ] = − D K L ( P 0 ‖ P 1 ) ≤ 0 . {\mathbb E_0[\log r(Y)]=-D_{\mathrm{KL}}(P_0\Vert P_1)\le0.} log r ( Y ) \log r(Y)
为什么不能交换 KL
的顺序?一个 Bernoulli 例子
取
P 1 = Ber ( 0.8 ) P_1=\operatorname{Ber}(0.8) P 0 = Ber ( 0.5 ) P_0=\operatorname{Ber}(0.5) D K L ( P 1 ‖ P 0 ) = 0.8 log 1.6 + 0.2 log 0.4 = 0.192745 , D K L ( P 0 ‖ P 1 ) = 0.5 log 0.625 + 0.5 log 2.5 = 0.223144 . \begin{align*}
D_{\mathrm{KL}}(P_1\Vert P_0)
&=0.8\log1.6+0.2\log0.4=0.192745,\\
D_{\mathrm{KL}}(P_0\Vert P_1)
&=0.5\log0.625+0.5\log2.5=0.223144.
\end{align*} P 1 P_1 80 % 80\% P 0 P_0
独立样本把信息相加
若
Y 1 , … , Y n Y_1,\ldots,Y_n log r n = log ∏ i f 1 ( Y i ) ∏ i f 0 ( Y i ) = ∑ i = 1 n log f 1 ( Y i ) f 0 ( Y i ) . \log r_n=\log\frac{\prod_i f_1(Y_i)}{\prod_i f_0(Y_i)}
=\sum_{i=1}^n\log\frac{f_1(Y_i)}{f_0(Y_i)}. D K L ( P 1 ⊗ n ‖ P 0 ⊗ n ) = n D K L ( P 1 ‖ P 0 ) . D_{\mathrm{KL}}(P_1^{\otimes n}\Vert P_0^{\otimes n})
=nD_{\mathrm{KL}}(P_1\Vert P_0). 1 n log r n → P 1 a . s . D K L ( P 1 ‖ P 0 ) , 1 n log r n → P 0 a . s . − D K L ( P 0 ‖ P 1 ) . \frac1n\log r_n\xrightarrow[P_1]{\mathrm{a.s.}}D_{\mathrm{KL}}(P_1\Vert P_0),
\qquad
\frac1n\log r_n\xrightarrow[P_0]{\mathrm{a.s.}}-D_{\mathrm{KL}}(P_0\Vert P_1).
单次证据与平均证据不同
r n r_n log r n \log r_n n n
最大似然为什么可以理解为寻找
KL 最近的模型?
设真实分布为
P P Q θ Q_\theta D K L ( P ‖ Q θ ) = 𝔼 P [ log p ( Y ) ] − 𝔼 P [ log q θ ( Y ) ] . D_{\mathrm{KL}}(P\Vert Q_\theta)
=\mathbb E_P[\log p(Y)]-\mathbb E_P[\log q_\theta(Y)]. θ \theta arg min θ D K L ( P ‖ Q θ ) = arg max θ 𝔼 P [ log q θ ( Y ) ] . {\arg\min_\theta D_{\mathrm{KL}}(P\Vert Q_\theta)
=\arg\max_\theta\mathbb E_P[\log q_\theta(Y)].} θ ̂ = arg max θ 1 n ∑ i log q θ ( y i ) . \hat\theta=\arg\max_\theta\frac1n\sum_i\log q_\theta(y_i).
有限分类数据:样本版本也可精确写成
KL
若观察类别
1 , … , m 1,\ldots,m n j n_j p ̂ j = n j / n \hat p_j=n_j/n ℓ ( q ) n = ∑ j p ̂ j log q j + 不含 q 的常数 , \frac{\ell(q)}n=\sum_j\hat p_j\log q_j+\text{不含 }q\text{ 的常数}, D K L ( P ̂ ‖ Q ) = ∑ j p ̂ j log p ̂ j − ∑ j p ̂ j log q j . D_{\mathrm{KL}}(\hat P\Vert Q)=\sum_j\hat p_j\log\hat p_j-
\sum_j\hat p_j\log q_j. 精确等于 最小化经验类别分布到候选分布的
KL。
连续响应时,不要照搬“经验分布的 KL” 连续模型
Q Q P ̂ n \hat P_n D K L ( P ̂ n ‖ Q ) = ∞ D_{\mathrm{KL}}(\hat P_n\Vert Q)=\infty ∑ i log q θ ( y i ) \sum_i\log q_\theta(y_i) 密度 得分;
它近似的是总体交叉熵目标,而不是这个无穷大的经验 KL。
取对数、乘 2
与卡方:各自做了什么?
对嵌套模型,Λ = sup Θ 0 L / sup Θ 1 L ≤ 1 \Lambda=\sup_{\Theta_0}L/\sup_{\Theta_1}L\le1 1 / 2 1/2
先看一个参数、简单原假设的二次近似
若完整 MLE 为内部点
θ ̂ \hat\theta ℓ ( θ 0 ) ≈ ℓ ( θ ̂ ) − 1 2 I n ( θ ̂ ) ( θ 0 − θ ̂ ) 2 . \ell(\theta_0)\approx\ell(\hat\theta)
-\frac12 I_n(\hat\theta)(\theta_0-\hat\theta)^2. G 2 = 2 { ℓ ( θ ̂ ) − ℓ ( θ 0 ) } ≈ I n ( θ ̂ ) ( θ ̂ − θ 0 ) 2 . G^2=2\{\ell(\hat\theta)-\ell(\theta_0)\}
\approx I_n(\hat\theta)(\hat\theta-\theta_0)^2. I n ( θ ̂ − θ 0 ) ∼ ̇ N ( 0 , 1 ) \sqrt{I_n}(\hat\theta-\theta_0)\dot\sim N(0,1) χ 1 2 \chi^2_1
多个参数与多个限制
若原假设施加
q q q q G 2 = − 2 log Λ → H 0 d χ q 2 . {G^2=-2\log\Lambda\xrightarrow[H_0]{d}\chi^2_q.}
Neyman–Pearson 和 Wilks 回答不同的问题
Neyman–Pearson:在两个已指定分布之间,给定大小的检验怎样最有力?这是有限样本最优性。
Wilks:某类复合模型的
− 2 log Λ -2\log\Lambda
在原假设下用什么大样本分布校准?这是渐近分布。
前者不需要正态近似,后者也不自动赋予一般 GLR 最强力性质。
边界、混合模型、完全分离及高维参数增长等情形,可能不满足这一简单的卡方结论。
更深一层:KL
控制检验错误下降的指数
这一节是选读。考虑独立同分布样本,H 0 = P 0 H_0=P_0 H 1 = P 1 H_1=P_1 0 < α < 1 0<\alpha<1 β n * ( α ) \beta_n^*(\alpha) log ( f 0 / f 1 ) \log(f_0/f_1) P 0 P_0 K = D K L ( P 0 ‖ P 1 ) < ∞ K=D_{\mathrm{KL}}(P_0\Vert P_1)<\infty lim n → ∞ − 1 n log β n * ( α ) = D K L ( P 0 ‖ P 1 ) . {\lim_{n\to\infty}-\frac1n\log\beta_n^*(\alpha)
=D_{\mathrm{KL}}(P_0\Vert P_1).} P 0 ‖ P 1 P_0\Vert P_1 P 1 P_1 1 − α 1-\alpha P 0 P_0
上界:构造一个满足要求的接受区域
令
K = D K L ( P 0 ‖ P 1 ) K=D_{\mathrm{KL}}(P_0\Vert P_1) T n = log ( f 0 ( n ) / f 1 ( n ) ) T_n=\log(f_0^{(n)}/f_1^{(n)}) T n / n → K T_n/n\to K P 0 P_0 ϵ > 0 \epsilon>0 A n = { T n ≥ n ( K − ϵ ) } A_n=\{T_n\ge n(K-\epsilon)\} H 0 H_0 P 0 P_0 α \alpha P 1 ( A n ) = 𝔼 0 [ e − T n 𝟏 A n ] ≤ e − n ( K − ϵ ) . P_1(A_n)=\mathbb E_0[e^{-T_n}\mathbf1_{A_n}]
\le e^{-n(K-\epsilon)}.
下界:任何合法接受区域都不能无限缩小
对任意
A A P 0 ( A ) ≥ 1 − α P_0(A)\ge1-\alpha B n = { T n ≤ n ( K + ϵ ) } B_n=\{T_n\le n(K+\epsilon)\} P 0 ( B n ) → 1 P_0(B_n)\to1 P 1 ( A ) ≥ 𝔼 0 [ e − T n 𝟏 A ∩ B n ] ≥ e − n ( K + ϵ ) { 1 − α − o ( 1 ) } . P_1(A)\ge\mathbb E_0[e^{-T_n}\mathbf1_{A\cap B_n}]
\ge e^{-n(K+\epsilon)}\{1-\alpha-o(1)\}. n n ϵ ↓ 0 \epsilon\downarrow0 K K
这不是有限样本的精确错误公式 结论说明指数阶
β n * = exp { − n K + o ( n ) } \beta_n^*=\exp\{-nK+o(n)\} n n β n * = e − n K \beta_n^*=e^{-nK}
Deviance:把广义似然比的参照换成饱和模型
对一份固定数据
𝒚 = ( y 1 , … , y n ) \mathbf y=(y_1,\ldots,y_n) M M S S μ ̃ i = y i \tilde\mu_i=y_i Λ M = sup M L sup S L , D M * = − 2 log Λ M = 2 ( ℓ s a t − ℓ ̂ M ) . \Lambda_M=\frac{\sup_{M}L}{\sup_{S}L},\qquad
{D_M^*=-2\log\Lambda_M=2(\ell_{\mathrm{sat}}-\hat\ell_M).}
为什么总是非负?
M ⊂ S M\subset S ℓ ̂ M ≤ ℓ s a t \hat\ell_M\le\ell_{\mathrm{sat}} D M * = 0 D_M^*=0
延续课件的尺度约定
共同尺度为
a a D = a D * , D * = D / a . {D=aD^*,\qquad D^*=D/a.} D * D^* − 2 log Λ -2\log\Lambda D D a = 1 a=1 a = σ 2 a=\sigma^2 D = R S S D=\mathrm{RSS} D * = R S S / σ 2 D^*=\mathrm{RSS}/\sigma^2
两个嵌套模型的偏差差值
若
M 0 ⊂ M 1 ⊂ S M_0\subset M_1\subset S D 0 * − D 1 * = 2 { ( ℓ S − ℓ ̂ 0 ) − ( ℓ S − ℓ ̂ 1 ) } = 2 ( ℓ ̂ 1 − ℓ ̂ 0 ) = G 2 , \begin{align*}
D_0^*-D_1^*
&=2\{(\ell_S-\hat\ell_0)-(\ell_S-\hat\ell_1)\}\\
&=2(\hat\ell_1-\hat\ell_0)=G^2,
\end{align*} G 2 = ( D 0 − D 1 ) / a G^2=(D_0-D_1)/a
定义本身不包含“服从卡方”的保证
偏差的定义是似然差。其总量对
χ n − k 2 \chi^2_{n-k} n n
最直观的精确等式:多项频数的
G 2 = 2 n K L G^2=2n\,\mathrm{KL}
观察
m m n 1 , … , n m n_1,\ldots,n_m n = ∑ j n j n=\sum_jn_j q = ( q 1 , … , q m ) q=(q_1,\ldots,q_m) p ̂ j = n j / n \hat p_j=n_j/n
第 1
步:写出两个多项似然
L ( q ) = n ! ∏ j n j ! ∏ j q j n j , L ( p ̂ ) = n ! ∏ j n j ! ∏ j p ̂ j n j . L(q)=\frac{n!}{\prod_jn_j!}\prod_jq_j^{n_j},\qquad
L(\hat p)=\frac{n!}{\prod_jn_j!}\prod_j\hat p_j^{n_j}. G 2 = 2 { ℓ ( p ̂ ) − ℓ ( q ) } = 2 ∑ j n j log p ̂ j q j = 2 n ∑ j p ̂ j log p ̂ j q j = 2 n D K L ( P ̂ ‖ Q ) . \begin{align*}
G^2
&=2\{\ell(\hat p)-\ell(q)\}
=2\sum_jn_j\log\frac{\hat p_j}{q_j}\\
&=2n\sum_j\hat p_j\log\frac{\hat p_j}{q_j}
={2nD_{\mathrm{KL}}(\hat P\Vert Q)}.
\end{align*}
第 2
步:解释每个系数从哪里来
KL
是一次类别试验 的平均对数得分损失;n n
完整数值例子
取频数
( 10 , 20 , 30 ) (10,20,30) n = 60 n=60 q j = 1 / 3 q_j=1/3 p ̂ = ( 1 / 6 , 1 / 3 , 1 / 2 ) \hat p=(1/6,1/3,1/2) D K L ( P ̂ ‖ Q ) = 1 6 log 1 2 + 1 3 log 1 + 1 2 log 3 2 = 0.0872080 , D_{\mathrm{KL}}(\hat P\Vert Q)=\frac16\log\frac12+
\frac13\log1+\frac12\log\frac32=0.0872080, G 2 = 2 { 10 log 1 2 + 20 log 1 + 30 log 3 2 } = 10.464963 = 120 D K L ( P ̂ ‖ Q ) . G^2=2\left\{10\log\frac12+20\log1+30\log\frac32\right\}
=10.464963=120D_{\mathrm{KL}}(\hat P\Vert Q). χ 2 2 \chi^2_2
这里的“经验 KL”有明确的共同样本空间
两边都是类别集合
{ 1 , 2 , 3 } \{1,2,3\}
上的概率分布。 不能把类别概率的 KL 与另一种样本空间上的密度 KL
混为一谈,也不能把
n n
再乘一次。
一般指数族:为什么
deviance 等于模型间的 KL?
固定共同尺度
a > 0 a>0 f θ ( z ) = exp { z θ − b ( θ ) a + c ( z , a ) } , 𝔼 θ Z = b ′ ( θ ) = μ . f_\theta(z)=\exp\left\{\frac{z\theta-b(\theta)}a+c(z,a)\right\},
\qquad \mathbb E_\theta Z=b'(\theta)=\mu. f θ s f_{\theta_s} f θ m f_{\theta_m}
第 1
步:先求对数密度比,再取期望
log f θ s ( Z ) f θ m ( Z ) = Z ( θ s − θ m ) − b ( θ s ) + b ( θ m ) a . \log\frac{f_{\theta_s}(Z)}{f_{\theta_m}(Z)}
=\frac{Z(\theta_s-\theta_m)-b(\theta_s)+b(\theta_m)}a. c ( z , a ) c(z,a) D K L ( f θ s ‖ f θ m ) = b ′ ( θ s ) ( θ s − θ m ) − b ( θ s ) + b ( θ m ) a . D_{\mathrm{KL}}(f_{\theta_s}\Vert f_{\theta_m})
=\frac{b'(\theta_s)(\theta_s-\theta_m)-b(\theta_s)+b(\theta_m)}a.
第 2
步:饱和均值把期望换成观测值
对已观察到的
y i y_i b ′ ( θ ̃ i ) = y i b'(\tilde\theta_i)=y_i θ ̂ i \hat\theta_i 2 D K L ( f θ ̃ i ‖ f θ ̂ i ) = 2 a { y i ( θ ̃ i − θ ̂ i ) − b ( θ ̃ i ) + b ( θ ̂ i ) } = d i a . 2D_{\mathrm{KL}}(f_{\tilde\theta_i}\Vert f_{\hat\theta_i})
=\frac2a\{y_i(\tilde\theta_i-\hat\theta_i)-b(\tilde\theta_i)+b(\hat\theta_i)\}
=\frac{d_i}a. D * = D a = 2 ∑ i D K L ( f θ ̃ i ‖ f θ ̂ i ) . {D^*=\frac Da
=2\sum_iD_{\mathrm{KL}}(f_{\tilde\theta_i}\Vert f_{\hat\theta_i}).}
这个等式精确,但要读清楚左右两边的对象
先固定数据,再把“饱和拟合”和“受限拟合”看作两个概率模型,计算它们之间的
KL。
这不表示饱和模型就是真实分布,也不表示把观测点组成的经验分布当作左边总能得到同一个
KL。
边界均值要取适当极限;若左右使用不同尺度,c c
这个证明没有使用
η = θ \eta=\theta canonical
link 并不是该等式成立的必要条件 。
链接只限制允许出现的拟合均值向量;同族同尺度的逐点 KL 公式仍然成立。
Poisson:KL
的公式就是单位偏差的一半
设
P = Pois ( λ ) P=\operatorname{Pois}(\lambda) Q = Pois ( μ ) Q=\operatorname{Pois}(\mu) λ , μ > 0 \lambda,\mu>0 log p ( Z ) q ( Z ) = Z log λ μ − λ + μ . \log\frac{p(Z)}{q(Z)}=Z\log\frac\lambda\mu-\lambda+\mu. 𝔼 P Z = λ \mathbb E_P Z=\lambda D K L ( Pois ( λ ) ‖ Pois ( μ ) ) = λ log λ μ − λ + μ . {D_{\mathrm{KL}}(\operatorname{Pois}(\lambda)\Vert\operatorname{Pois}(\mu))
=\lambda\log\frac\lambda\mu-\lambda+\mu.} λ = y \lambda=y d ( y , μ ) = 2 { y log y μ − y + μ } = 2 D K L ( Pois ( y ) ‖ Pois ( μ ) ) . d(y,\mu)=2\left\{y\log\frac y\mu-y+\mu\right\}=2D_{\mathrm{KL}}(\operatorname{Pois}(y)\Vert\operatorname{Pois}(\mu)). a = 1 a=1 D = D * D=D^*
零计数怎样处理?
Pois ( 0 ) \operatorname{Pois}(0) D K L ( Pois ( 0 ) ‖ Pois ( μ ) ) = log 1 Q ( Z = 0 ) = μ , d ( 0 , μ ) = 2 μ . D_{\mathrm{KL}}(\operatorname{Pois}(0)\Vert\operatorname{Pois}(\mu))
=\log\frac1{Q(Z=0)}=\mu,
\quad d(0,\mu)=2\mu. y log y → 0 y\log y\to0 Pois ( μ ) \operatorname{Pois}(\mu) Pois ( 0 ) \operatorname{Pois}(0)
三行数据的手算
给定观测
y = ( 0 , 2 , 4 ) y=(0,2,4) μ = ( 1 , 2 , 3 ) \mu=(1,2,3) K L i = ( 1 , 0 , 4 log ( 4 / 3 ) − 1 ) = ( 1 , 0 , 0.150728 ) , \mathrm{KL}_i=\left(1,\ 0,\ 4\log(4/3)-1\right)
=(1,0,0.150728), D = 2 ∑ i K L i = 2.301457 . D=2\sum_i\mathrm{KL}_i=2.301457.
“饱和 Poisson”与“观测点的点质量”不同 当
y = 2 y=2 Pois ( 2 ) \operatorname{Pois}(2) δ 2 \delta_2 D K L ( δ 2 ‖ Pois ( μ ) ) = − log q ( 2 ) D_{\mathrm{KL}}(\delta_2\Vert\operatorname{Pois}(\mu))=-\log q(2)
二项与
Bernoulli:n n
对一次 Bernoulli 试验,成功率分别为
s , p s,p D K L ( Ber ( s ) ‖ Ber ( p ) ) = s log s p + ( 1 − s ) log 1 − s 1 − p . D_{\mathrm{KL}}(\operatorname{Ber}(s)\Vert\operatorname{Ber}(p))
=s\log\frac sp+(1-s)\log\frac{1-s}{1-p}. S ∼ Bin ( n , p ) S\sim\operatorname{Bin}(n,p) n n D K L ( Bin ( n , s ) ‖ Bin ( n , p ) ) = n D K L ( Ber ( s ) ‖ Ber ( p ) ) . D_{\mathrm{KL}}(\operatorname{Bin}(n,s)\Vert\operatorname{Bin}(n,p))
=nD_{\mathrm{KL}}(\operatorname{Ber}(s)\Vert\operatorname{Ber}(p)). 𝔼 s S = n s \mathbb E_sS=ns
给定总数
S = s o b s S=s_{\mathrm{obs}}
令
p ̂ = s o b s / n \hat p=s_{\mathrm{obs}}/n G 2 = 2 { ℓ ( p ̂ ) − ℓ ( p 0 ) } = 2 { s o b s log p ̂ p 0 + ( n − s o b s ) log 1 − p ̂ 1 − p 0 } = 2 n D K L ( Ber ( p ̂ ) ‖ Ber ( p 0 ) ) = 2 D K L ( Bin ( n , p ̂ ) ‖ Bin ( n , p 0 ) ) . \begin{align*}
G^2
&=2\{\ell(\hat p)-\ell(p_0)\}\\
&=2\left\{s_{\mathrm{obs}}\log\frac{\hat p}{p_0}
+(n-s_{\mathrm{obs}})\log\frac{1-\hat p}{1-p_0}\right\}\\
&=2nD_{\mathrm{KL}}(\operatorname{Ber}(\hat p)\Vert\operatorname{Ber}(p_0))\\
&=2D_{\mathrm{KL}}(\operatorname{Bin}(n,\hat p)\Vert\operatorname{Bin}(n,p_0)).
\end{align*} n n n n n = 10 , S = 8 , p 0 = 0.5 n=10,S=8,p_0=0.5 G 2 = 20 { 0.8 log 1.6 + 0.2 log 0.4 } = 3.854895 . G^2=20\{0.8\log1.6+0.2\log0.4\}=3.854895.
若把每次
Bernoulli 分别视为一行数据
逐行饱和模型允许各
p i = y i ∈ { 0 , 1 } p_i=y_i\in\{0,1\} p p 总残差偏差 为
D ( p ) = − 2 { S log p + ( n − S ) log ( 1 − p ) } . D(p)=-2\{S\log p+(n-S)\log(1-p)\}. p 0 p_0 p ̂ \hat p D ( p 0 ) − D ( p ̂ ) = G 2 D(p_0)-D(\hat p)=G^2
先交代数据单位,再交代 KL 和 deviance
一次
Bernoulli、一个二项总数、一个逐行饱和模型,是三个不同的统计对象。
模型比较的似然比可以一致,但“每次试验的信息量”和“总残差偏差”不能不加区分地互换。
正态模型:平方误差为什么也是
KL?
取
P = N ( m , σ 2 ) P=N(m,\sigma^2) Q = N ( μ , σ 2 ) Q=N(\mu,\sigma^2) log p ( Z ) q ( Z ) = ( Z − μ ) 2 − ( Z − m ) 2 2 σ 2 . \log\frac{p(Z)}{q(Z)}
=\frac{(Z-\mu)^2-(Z-m)^2}{2\sigma^2}. P P 𝔼 ( Z − μ ) 2 = σ 2 + ( m − μ ) 2 \mathbb E(Z-\mu)^2=\sigma^2+(m-\mu)^2 D K L ( N ( m , σ 2 ) ‖ N ( μ , σ 2 ) ) = ( m − μ ) 2 2 σ 2 . {D_{\mathrm{KL}}(N(m,\sigma^2)\Vert N(\mu,\sigma^2))
=\frac{(m-\mu)^2}{2\sigma^2}.} m = y i m=y_i D * = 2 ∑ i D K L ( N ( y i , σ 2 ) ‖ N ( μ ̂ i , σ 2 ) ) = ∑ i ( y i − μ ̂ i ) 2 σ 2 , D^*=2\sum_iD_{\mathrm{KL}}(N(y_i,\sigma^2)\Vert N(\hat\mu_i,\sigma^2))
=\frac{\sum_i(y_i-\hat\mu_i)^2}{\sigma^2}, D = R S S , D * = D / σ 2 . {D=\mathrm{RSS},\qquad D^*=D/\sigma^2.}
与前面讲义的三点数据接起来
取
x = ( 0 , 1 , 2 ) x=(0,1,2) y = ( 1 , 2 , 4 ) y=(1,2,4) 𝜷 ̂ = ( 5 / 6 , 3 / 2 ) 𝖳 , R S S = 1 / 6 . \hat{\boldsymbol\beta}=(5/6,3/2)^\mathsf T,\qquad \mathrm{RSS}=1/6. σ 2 = 2 \sigma^2=2 D = 1 / 6 D=1/6 D * = 1 / 12 D^*=1/12 1 / 24 1/24
方差也要估计时,哪些公式必须改变?
若各模型分别最大化未知
σ 2 \sigma^2 G 2 = n log R S S 0 R S S 1 , G^2=n\log\frac{\mathrm{RSS}_0}{\mathrm{RSS}_1}, R S S 0 = 14 / 3 \mathrm{RSS}_0=14/3 R S S 1 = 1 / 6 \mathrm{RSS}_1=1/6 G 2 = 3 log 28 = 9.996614 G^2=3\log28=9.996614
饱和模型的方差不能一起放到零 若每个均值均取
y i y_i σ 2 ↓ 0 \sigma^2\downarrow0
偏差之差也等于两个拟合模型之间的
KL 吗?
一般情况下,已知
G 2 = D 0 * − D 1 * = 2 ∑ i { D K L ( S i ‖ M 0 i ) − D K L ( S i ‖ M 1 i ) } , G^2=D_0^*-D_1^*
=2\sum_i\{D_{\mathrm{KL}}(S_i\Vert M_{0i})-D_{\mathrm{KL}}(S_i\Vert M_{1i})\}, 并不能仅靠相减 就改写成
2 ∑ i D K L ( M 1 i ‖ M 0 i ) 2\sum_iD_{\mathrm{KL}}(M_{1i}\Vert M_{0i})
嵌套
canonical GLM 中的精确抵消
设两个模型同族、同固定尺度
a a θ ̂ 1 = X 1 𝜷 ̂ 1 \hat\theta_1=X_1\hat{\boldsymbol\beta}_1 θ ̂ 0 = X 0 𝜷 ̂ 0 \hat\theta_0=X_0\hat{\boldsymbol\beta}_0 𝒞 ( X 0 ) ⊂ 𝒞 ( X 1 ) \mathcal C(X_0)\subset\mathcal C(X_1) X 1 𝖳 ( 𝒚 − 𝝁 ̂ 1 ) = 0 . X_1^\mathsf T(\mathbf y-\hat{\boldsymbol\mu}_1)=0. θ ̂ 1 − θ ̂ 0 \hat\theta_1-\hat\theta_0 X 1 X_1 ∑ i ( y i − μ ̂ 1 i ) ( θ ̂ 1 i − θ ̂ 0 i ) = 0 . \sum_i(y_i-\hat\mu_{1i})(\hat\theta_{1i}-\hat\theta_{0i})=0. ℓ ̂ 1 − ℓ ̂ 0 = 1 a ∑ i { y i ( θ ̂ 1 i − θ ̂ 0 i ) − b ( θ ̂ 1 i ) + b ( θ ̂ 0 i ) } , ∑ i D K L ( M 1 i ‖ M 0 i ) = 1 a ∑ i { μ ̂ 1 i ( θ ̂ 1 i − θ ̂ 0 i ) − b ( θ ̂ 1 i ) + b ( θ ̂ 0 i ) } . \begin{align*}
\hat\ell_1-\hat\ell_0
&=\frac1a\sum_i\{y_i(\hat\theta_{1i}-\hat\theta_{0i})
-b(\hat\theta_{1i})+b(\hat\theta_{0i})\},\\
\sum_iD_{\mathrm{KL}}(M_{1i}\Vert M_{0i})
&=\frac1a\sum_i\{\hat\mu_{1i}(\hat\theta_{1i}-\hat\theta_{0i})
-b(\hat\theta_{1i})+b(\hat\theta_{0i})\}.
\end{align*} G 2 = 2 ∑ i D K L ( M 1 i ‖ M 0 i ) . {G^2=2\sum_iD_{\mathrm{KL}}(M_{1i}\Vert M_{0i}).}
把两个结论分开记
饱和模型到拟合模型的逐点 KL
等式,不要求 canonical link。
两个受限拟合模型之间也要建立上述等式,则需要额外条件;这里的
canonical、嵌套与得分正交性 给出了一组充分条件。非 canonical
时不能未经核对就照搬,但也不能断言永远不成立。
再沿参数链走一遍:KL
的局部曲率就是 Fisher 信息
本节把前面几章的
θ , μ , η , 𝜷 \theta,\mu,\eta,\boldsymbol\beta a a θ \theta θ + δ θ \theta+\delta\theta D K L ( f θ ‖ f θ + δ θ ) = b ( θ + δ θ ) − b ( θ ) − b ′ ( θ ) δ θ a . D_{\mathrm{KL}}(f_\theta\Vert f_{\theta+\delta\theta})
=\frac{b(\theta+\delta\theta)-b(\theta)-b'(\theta)\delta\theta}a.
第 1
步:一阶项抵消,留下二阶曲率
Taylor 展开
b b D K L ( f θ ‖ f θ + δ θ ) = b ″ ( θ ) 2 a ( δ θ ) 2 + o ( ( δ θ ) 2 ) . D_{\mathrm{KL}}(f_\theta\Vert f_{\theta+\delta\theta})
=\frac{b''(\theta)}{2a}(\delta\theta)^2+o((\delta\theta)^2). b ″ ( θ ) = V ( μ ) b''(\theta)=V(\mu) d μ / d θ = V ( μ ) d\mu/d\theta=V(\mu) δ μ ≈ V ( μ ) δ θ , D K L ≈ ( δ μ ) 2 2 a V ( μ ) . \delta\mu\approx V(\mu)\delta\theta,
\qquad
D_{\mathrm{KL}}\approx\frac{(\delta\mu)^2}{2aV(\mu)}.
第 2
步:把均值误差继续传回回归系数
由
η = g ( μ ) = 𝒙 𝖳 𝜷 \eta=g(\mu)=\mathbf x^\mathsf T\boldsymbol\beta δ μ ≈ δ η g ′ ( μ ) = 𝒙 𝖳 δ 𝜷 g ′ ( μ ) . \delta\mu\approx\frac{\delta\eta}{g'(\mu)}
=\frac{\mathbf x^\mathsf T\delta\boldsymbol\beta}{g'(\mu)}. ∑ i D K L ( f i ( 𝜷 ) ‖ f i ( 𝜷 + δ 𝜷 ) ) ≈ 1 2 a ∑ i ( 𝒙 i 𝖳 δ 𝜷 ) 2 V ( μ i ) { g ′ ( μ i ) } 2 = 1 2 δ 𝜷 𝖳 ( 1 a X 𝖳 W X ) ⏟ I ( 𝜷 ) δ 𝜷 . \begin{align*}
\sum_iD_{\mathrm{KL}}(f_i(\boldsymbol\beta)\Vert f_i(\boldsymbol\beta+\delta\boldsymbol\beta))
&\approx\frac1{2a}\sum_i
\frac{(\mathbf x_i^\mathsf T\delta\boldsymbol\beta)^2}{V(\mu_i)\{g'(\mu_i)\}^2}\\
&=\frac12\delta\boldsymbol\beta^\mathsf T
\underbrace{\left(\frac1aX^\mathsf TWX\right)}_{I(\boldsymbol\beta)}\delta\boldsymbol\beta.
\end{align*} W = diag ( w 1 , … , w n ) W=\mathop{\mathrm{diag}}(w_1,\ldots,w_n) w i = [ V ( μ i ) { g ′ ( μ i ) } 2 ] − 1 w_i=[V(\mu_i)\{g'(\mu_i)\}^2]^{-1}
为什么信息矩阵同时出现在估计、检验和 KL 中?
它衡量邻近参数对应的分布有多容易区分。相同的参数位移,若沿信息大的方向发生,
KL 增加较多;参数估计在该方向上的方差通常较小。 Wald 的二次型、LR
的局部二次近似与 KL 的局部曲率因此共享同一个矩阵。
这个式子描述局部近似;它不把全局非对称的 KL 变成全局欧氏距离。
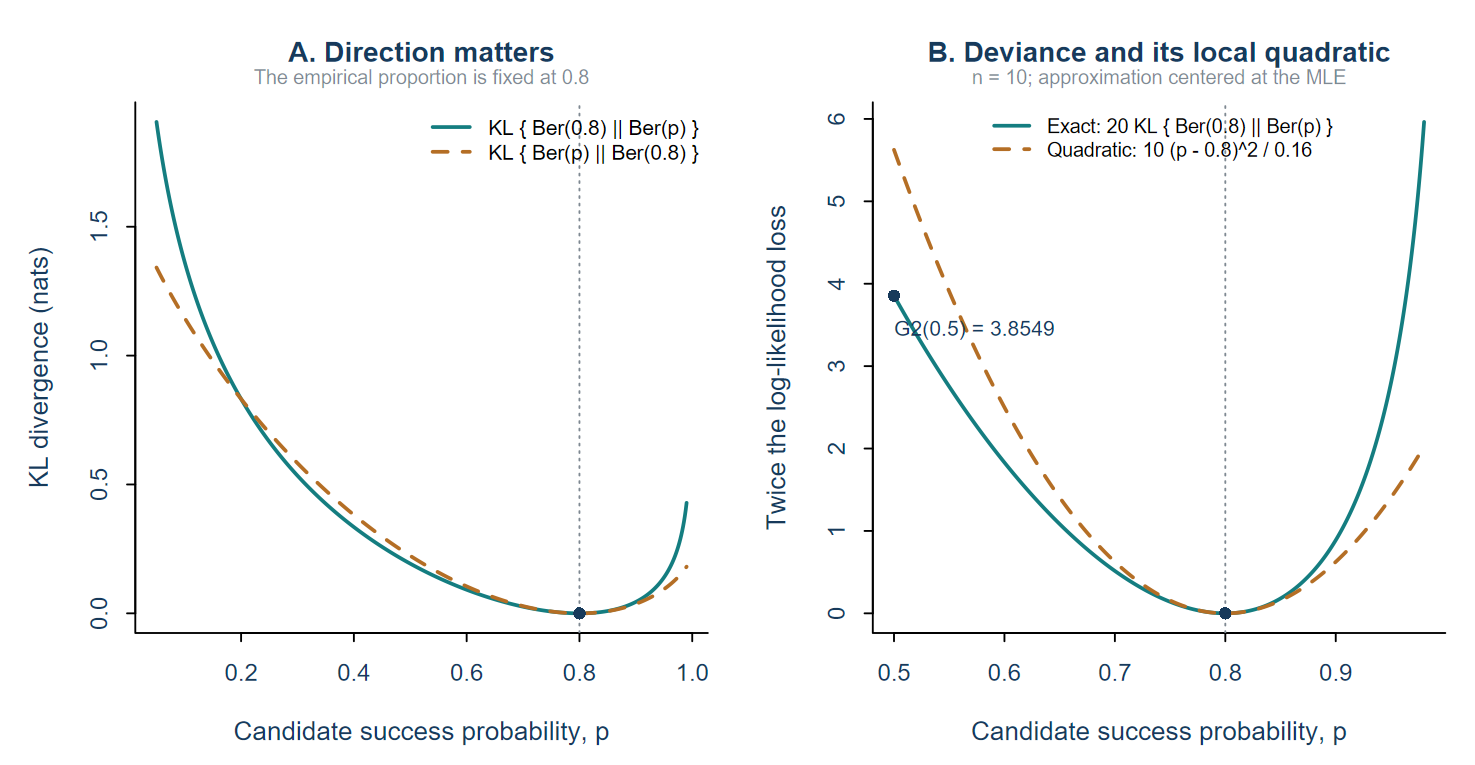
看图:KL
的方向、deviance 的尺度与局部近似
固定观察比例
p ̂ = 0.8 \hat p=0.8 n = 10 n=10 p p
图 2:Bernoulli 的 KL(每个试验,单位 nats)与二项计数的偏差:后者是前者的 2n 倍。局部二次近似以 p̂ = 0.8 为中心,仅在 0.8 附近准确,并非对 p 一致成立。
左图:交换左右分布,就改变了取平均的方式
两条曲线都是非负的,并且只在
p = 0.8 p=0.8 D K L ( Ber ( 0.8 ) ‖ Ber ( p ) ) D_{\mathrm{KL}}(\operatorname{Ber}(0.8)\Vert\operatorname{Ber}(p)) p p 1 − p 1-p
右图:为什么 deviance 在
MLE 附近像平方距离?
本例的精确统计量为
G 2 ( p ) = 20 D K L ( Ber ( 0.8 ) ‖ Ber ( p ) ) . G^2(p)=20D_{\mathrm{KL}}(\operatorname{Ber}(0.8)\Vert\operatorname{Ber}(p)). p = 0.8 p=0.8 n / [ p ( 1 − p ) ] n/[p(1-p)] G 2 ( p ) ≈ 10 ( p − 0.8 ) 2 0.8 ( 1 − 0.8 ) . G^2(p)\approx\frac{10(p-0.8)^2}{0.8(1-0.8)}. p = 0.5 p=0.5 3.854895 3.854895 5.625 5.625
同一个统计量的近似校准也可能不够准确 若把本例的
G 2 = 3.854895 G^2=3.854895 χ 1 2 \chi^2_1 p = 0.049601 p=0.049601 Bin ( 10 , 0.5 ) \operatorname{Bin}(10,0.5) 0.109375 0.109375
可选的统一表达:偏差来自凸函数的切线误差
在一参数指数族内部,定义
b b F ( μ ) = μ θ ( μ ) − b ( θ ( μ ) ) , θ ( μ ) = ( b ′ ) − 1 ( μ ) . F(\mu)=\mu\theta(\mu)-b(\theta(\mu)),
\qquad \theta(\mu)=(b')^{-1}(\mu). b ′ ( θ ( μ ) ) = μ b'(\theta(\mu))=\mu F ′ ( μ ) = θ ( μ ) , F ″ ( μ ) = 1 V ( μ ) > 0 . F'(\mu)=\theta(\mu),\qquad F''(\mu)=\frac1{V(\mu)}>0. F F μ \mu F ( y ) − F ( μ ) − F ′ ( μ ) ( y − μ ) = y θ ( y ) − b ( θ ( y ) ) − μ θ ( μ ) + b ( θ ( μ ) ) − θ ( μ ) ( y − μ ) = y { θ ( y ) − θ ( μ ) } − b ( θ ( y ) ) + b ( θ ( μ ) ) = 1 2 d ( y , μ ) . \begin{align*}
F(y)-F(\mu)-F'(\mu)(y-\mu)
&=y\theta(y)-b(\theta(y))-\mu\theta(\mu)+b(\theta(\mu))\\
&\quad-\theta(\mu)(y-\mu)\\
&=y\{\theta(y)-\theta(\mu)\}-b(\theta(y))+b(\theta(\mu))\\
&=\frac12d(y,\mu).
\end{align*}
这解释了什么?
凸函数位于任意切线之上,所以单位偏差非负。
函数本身与在某点画出的切线扮演不同角色,这也解释了通常的不对称性。
该表达常称为均值空间上的 Bregman
散度;不需要记这个名称也能使用上面的推导。
分布族
可取的
F ( μ ) F(\mu)
d ( y , μ ) / 2 d(y,\mu)/2
正态,V = 1 V=1
μ 2 / 2 \mu^2/2 ( y − μ ) 2 / 2 (y-\mu)^2/2
Poisson
μ log μ − μ \mu\log\mu-\mu y log ( y / μ ) − y + μ y\log(y/\mu)-y+\mu
Bernoulli
μ log μ + ( 1 − μ ) log ( 1 − μ ) \mu\log\mu+(1-\mu)\log(1-\mu) D K L ( Ber ( y ) ‖ Ber ( μ ) ) D_{\mathrm{KL}}(\operatorname{Ber}(y)\Vert\operatorname{Ber}(\mu))
表中 Bernoulli 的
y = 0 , 1 y=0,1 F F
回到最初的问题
似然差、KL
与平方误差不是三个互不相关的技巧。 在指数族里,它们都与同一个凸函数
b b
或其均值参数表达
F F
相连; 平方误差是正态族的精确形式,也是其他光滑模型的局部二次近似。
历史(一):从似然到检验的最优性与标定
先分清历史顺序与讲解顺序
本讲义用同一个对数密度比串起几个概念,是为了看清数学关系。历史上,它们分别回应参数估计、错误概率控制、通信和模型拟合等问题;不能把今天的推导顺序当作当年的发明顺序。
1922:Fisher——观察到数据以后,如何比较参数?
Fisher
的论文系统讨论参数、统计量、估计和充分性。第326–327页明确区分:给定参数时数据的概率,与固定已观测数据后各参数值的相对似然。用今天的记号,
L ( ϑ ; y ) = f ϑ ( y ) , ϑ ̂ ∈ arg max ϑ L ( ϑ ; y ) . L(\vartheta;y)=f_{\vartheta}(y),\qquad
\hat\vartheta\in\arg\max_{\vartheta}L(\vartheta;y). 如何估计参数 ;L ( ϑ ; y ) L(\vartheta;y)
原始文献:Fisher (1922),
Mathematical Foundations ,尤其第6节。
1928:Neyman–Pearson——用似然比较假设
两人开始系统研究检验准则、备择假设和两类错误。Part I
第187–190页的例子已把受限制模型的最大似然与更大模型的最大似然作比,得到今天熟悉的似然比形式。构造出一个自然准则,与证明它最优,是两个步骤。 原文也没有把所有此类准则都宣称为最优。
原始文献:Neyman–Pearson (1928),
Certain Test Criteria , Part I 。
1933:Neyman–Pearson——在固定错误预算下怎样最强?
第298–301页研究简单假设
P 0 P_0 P 1 P_1 P 1 P_1 max φ : 𝔼 0 φ ≤ α 𝔼 1 φ , φ * ( y ) = 𝟏 { f 1 ( y ) f 0 ( y ) > c } (必要时边界随机化)。 \max_{\varphi:\,\mathbb E_0\varphi\leq\alpha}\mathbb E_1\varphi,
\qquad \varphi^*(y)=\mathbf1\!\left\{\frac{f_1(y)}{f_0(y)}>c\right\}
\quad\text{(必要时边界随机化)。} 检验功效的最优性 。复合备择中的不同方向可能要求不同拒绝域,因此不能推出“一般
GLR 都一致最强力”。
原始文献:Neyman–Pearson (1933),
Most Efficient Tests ,第III节。
1938:Wilks——有了似然比,临界值从哪里来?
Wilks
研究复合假设下似然比的大样本分布。现代常用表述是:在适当正则条件、固定维数及内点真值下,嵌套模型的
− 2 log Λ -2\log\Lambda χ 2 \chi^2 如何标定显著性 ,与 NP
的有限样本功效最优性是不同结论。
原始文献:Wilks (1938),
Large-Sample Distribution of the Likelihood
Ratio 。
历史(二):信息论与 GLM 的汇合
1948:Shannon——通信中的不确定性与编码极限
Shannon
研究消息怎样通过信道传输、噪声如何限制通信,以及消息的统计结构能节省多少编码长度。对离散分布,他系统发展了对数形式的熵
H ( P ) = − ∑ x p ( x ) log p ( x ) . H(P)=-\sum_xp(x)\log p(x).
原始文献:Shannon
(1948), A Mathematical Theory of
Communication ,尤其第6节。
1951:Kullback–Leibler——区分分布需要多少信息?
On Information and Sufficiency
将信息度量与统计分布的区分、充分统计量联系起来。今天记作 KL 散度的量为
D K L ( P ‖ Q ) = 𝔼 P [ log p ( Y ) q ( Y ) ] . D_{\mathrm{KL}}(P\Vert Q)=\mathbb E_P\!\left[\log\frac{p(Y)}{q(Y)}\right]. 某次观测的统计量 ;KL
是在指定分布下对该量取总体平均 。所以 KL 并不是把 NP
检验换一个名字:一个描述平均辨别信息,另一个规定如何在第一类错误约束下分配拒绝域。
原始文献:Kullback–Leibler (1951),
On Information and Sufficiency 。本讲义采用今天通行的非对称
KL 记号。
1972:Nelder–Wedderburn——统一
GLM 的拟合比较
他们将若干回归模型放入广义线性模型框架,讨论指数族、链接函数、迭代拟合及模型比较。第375页明确提出将以完整模型为参照的似然失配量称为
deviance ,原文用语是“which we propose to call the
deviance”。按本讲义的记号,这个参照思想写成
D * = 2 { ℓ s a t − ℓ f i t } . D^*=2\{\ell_{\mathrm sat}-\ell_{\mathrm fit}\}. 最大化后的似然及其完整模型参照 。本讲义随后证明的
KL 表达式展示数学联系,不是断言原作者按“先 KL、后
deviance”的路线发明它。
原始文献:Nelder–Wedderburn (1972),
Generalized Linear Models ,第375页。
阅读历史文献时还要核对尺度约定 1972年论文中,正态例子的
deviance 是
R S S / σ 2 \mathrm{RSS}/\sigma^2 D D D * = D / a D^*=D/a D = R S S D=\mathrm{RSS} D * = R S S / σ 2 D^*=\mathrm{RSS}/\sigma^2
把四个概念放回同一条推导链
第一层:一次数据,产生一个似然比
在两个固定分布之间,r ( Y ) = f 1 ( Y ) / f 0 ( Y ) r(Y)=f_1(Y)/f_0(Y) 固定 P 0 , P 1 → log r ( Y ) = log f 1 ( Y ) − log f 0 ( Y ) . {\text{固定 }P_0,P_1\quad\longrightarrow\quad
\log r(Y)=\log f_1(Y)-\log f_0(Y).}
第二层:两种不同操作,回答两种不同问题
对
r r 排序并选阈值 ,且约束
𝔼 0 φ ≤ α \mathbb E_0\varphi\le\alpha log r \log r 取期望 ,则得到有方向的 KL:
𝔼 1 log r = D K L ( P 1 ‖ P 0 ) , 𝔼 0 log r = − D K L ( P 0 ‖ P 1 ) . \mathbb E_1\log r=D_{\mathrm{KL}}(P_1\Vert P_0),\qquad
\mathbb E_0\log r=-D_{\mathrm{KL}}(P_0\Vert P_1).
第三层:允许各模型估计参数,得到
GLR
比较两个嵌套模型各自最好的似然,得到
G 2 = 2 ( ℓ ̂ 1 − ℓ ̂ 0 ) . G^2=2(\hat\ell_1-\hat\ell_0). G 2 G^2
第四层:完整模型取饱和模型,得到
deviance
对同族、同固定尺度的一参数指数族,并允许适当的饱和边界极限,
D * = 2 ( ℓ s a t − ℓ ̂ M ) = D a = 2 ∑ i D K L ( S i ‖ M i ) . {D^*=2(\ell_{\mathrm sat}-\hat\ell_M)
=\frac Da=2\sum_iD_{\mathrm{KL}}(S_i\Vert M_i).} 用这份数据拟合出的两个模型 之间的
KL。 等式成立的桥梁是
𝔼 S i Z = y i \mathbb E_{S_i}Z=y_i
遇到新公式时,按这四步核对
数据单位是什么:一次
Bernoulli、一个二项总数,还是整个独立样本?
比较谁与谁:固定分布、各自估计的模型,还是拟合模型与饱和模型?
计算的是实现值还是期望?若是 KL,左边分布提供什么权重?
是精确等式还是渐近近似?尺度是否固定,卡方条件是否成立?
代码核对:不用统计包也能复现关键等式
下面的 Python 只用标准库;完整文件为 worked_example.py。
它同时检查 NP 随机化、双侧 GLR 的精确尾概率,以及
G 2 = 2 n K L G^2=2n\,\mathrm{KL}
应看到的主要结果
量
数值
边界随机化概率
γ \gamma
0.89333333
NP size;在
p = 0.8 p=0.8
0.05000000;0.64558727
G 2 G^2 2 n K L 2n\,\mathrm{KL} 3.85489514;3.85489514
双侧 GLR
精确尾概率;χ 1 2 \chi^2_1
0.10937500;0.04960103
verify_numbers.py 还独立检查
Poisson、正态、多项例子及参数链。 make_figures.R 使用 base
R 生成本讲义的两张图,不需额外 R 包。
练习:先判断对象,再做运算
KL 的方向。 设
P 0 = Ber ( 0.5 ) P_0=\operatorname{Ber}(0.5) P 1 = Ber ( 0.8 ) P_1=\operatorname{Ber}(0.8) r n = ∏ i f 1 ( Y i ) / f 0 ( Y i ) r_n=\prod_i f_1(Y_i)/f_0(Y_i) n = 10 n=10 𝔼 1 log r n \mathbb E_1\log r_n 𝔼 0 log r n \mathbb E_0\log r_n
重新设计 NP 检验。 沿用
S ∼ Bin ( 10 , p ) S\sim\operatorname{Bin}(10,p) H 0 : p = 0.5 H_0:p=0.5 H 1 : p = 0.8 H_1:p=0.8 α = 0.10 \alpha=0.10
一次 Bernoulli 与一个二项总数。 当
S = 8 , n = 10 , p 0 = 0.5 S=8,n=10,p_0=0.5 D K L ( Ber ( 0.8 ) ‖ Ber ( 0.5 ) ) , D K L ( Bin ( 10 , 0.8 ) ‖ Bin ( 10 , 0.5 ) ) . D_{\mathrm{KL}}(\operatorname{Ber}(0.8)\Vert\operatorname{Ber}(0.5)),\qquad
D_{\mathrm{KL}}(\operatorname{Bin}(10,0.8)\Vert\operatorname{Bin}(10,0.5)). G 2 G^2
Poisson 的零计数。 对
y = 0 y=0 μ = 2 \mu=2 D K L ( Pois ( 0 ) ‖ Pois ( 2 ) ) D_{\mathrm{KL}}(\operatorname{Pois}(0)\Vert\operatorname{Pois}(2))
正态模型的尺度。 两个嵌套正态均值模型有
R S S 0 = 20 \mathrm{RSS}_0=20 R S S 1 = 12 \mathrm{RSS}_1=12 n = 10 n=10
辨别错误推理。 逐条说明下列说法为什么不成立:
“KL 非负,所以每次对数似然比都非负”; “GLR 使用似然比,所以由 NP
知道它总是最强力”; “残差 deviance 也是 LR,所以由 Wilks 知道它总服从
χ n − k 2 \chi^2_{n-k} D 0 * − D 1 * D_0^*-D_1^*
解题时不跳过条件
写出一个正确数字,还不够说明理解了公式。请在答案旁标明平均分布、数据单位、尺度约定,
并注明是否使用了渐近近似。下一页给出核对答案。
练习答案与关键理由
信息可加,故
𝔼 1 log r 10 = 10 ( 0.192744757 ) = 1.92744757 , 𝔼 0 log r 10 = − 10 ( 0.223143551 ) = − 2.23143551 . \mathbb E_1\log r_{10}=10(0.192744757)=1.92744757,
\quad \mathbb E_0\log r_{10}=-10(0.223143551)=-2.23143551. f 0 f_0
因为
P 0 ( S ≥ 8 ) = 56 / 1024 < 0.10 P_0(S\ge8)=56/1024<0.10 P 0 ( S ≥ 7 ) = 176 / 1024 > 0.10 P_0(S\ge7)=176/1024>0.10 S ≥ 8 S\ge8 S = 7 S=7 γ = 0.10 − 56 / 1024 120 / 1024 = 29 75 , p o w e r = P 1 ( S ≥ 8 ) + 29 75 P 1 ( S = 7 ) = 0.75564581 . \gamma=\frac{0.10-56/1024}{120/1024}=\frac{29}{75},
\quad \mathrm{power}=P_1(S\ge8)+\frac{29}{75}P_1(S=7)
=0.75564581. α \alpha
Bernoulli KL 为
0.192744757 0.192744757 1.927447570 1.927447570 2 n = 20 2n=20 3.854895140 3.854895140
Pois ( 0 ) \operatorname{Pois}(0) − log ( e − 2 ) = 2 -\log(e^{-2})=2 + ∞ +\infty
固定方差时
G 2 = ( 20 − 12 ) / 2 = 4 . G^2=(20-12)/2=4. σ ̂ j 2 = R S S j / n \hat\sigma_j^2=\mathrm{RSS}_j/n G 2 = 10 log ( 20 / 12 ) = 5.10825624 . G^2=10\log(20/12)=5.10825624.
非负的期望不要求每个实现值非负;GLR 的最大化似然包络不是 NP
中的固定密度; 饱和模型维数可能随样本量增长,不能直接套固定维数的
Wilks; KL 的差一般不是另一个 KL。最后一种等式在同族同尺度、嵌套
canonical 均值结构、内部 MLE
等充分条件下可由得分正交性证明,不能省略条件。
参考文献与继续阅读
历史部分依据以下原始论文的出版信息与可取得的原文。
正文的符号、随机化检验表达及统一推导采用现代教学记法;它们不等于原论文逐字表述。
点击文献题名可进入 DOI 页面。
Fisher, R. A. (1922). On the Mathematical
Foundations of Theoretical Statistics . Philosophical
Transactions of the Royal Society A , 222, 309–368.
本讲义主要参照第326–327页关于 probability 与 likelihood 的区别。
Neyman, J., & Pearson, E. S. (1928). On the Use and
Interpretation of Certain Test Criteria for Purposes of Statistical
Inference, Part I . Biometrika , 20A(1–2), 175–240.
似然比准则的例子见第187–190页。
Neyman, J., & Pearson, E. S. (1933). On the Problem of the Most
Efficient Tests of Statistical Hypotheses . Philosophical
Transactions of the Royal Society A , 231, 289–337.
简单假设的最优检验讨论见第298–301页。
Wilks, S. S. (1938). The Large-Sample
Distribution of the Likelihood Ratio for Testing Composite
Hypotheses . The Annals of Mathematical Statistics , 9(1),
60–62. 本讲义给出的是现代常用的正则模型表述与局部二次型解释。
Shannon, C. E. (1948). A Mathematical
Theory of Communication . The Bell System Technical Journal ,
27, 379–423, 623–656. 后半部分的
DOI 。 熵与通信问题为其背景,不应与 NP 引理的历史来源混同。
Kullback, S., & Leibler, R. A. (1951). On Information and
Sufficiency . The Annals of Mathematical Statistics , 22(1),
79–86. 信息度量、分布区分与统计充分性之间联系的原始论文。
Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized Linear Models .
Journal of the Royal Statistical Society, Series A , 135(3),
370–384. 第375页提出 deviance 的称呼;原文正态例子的量含方差尺度。
Polyanskiy, Y. (2016). MIT 6.441, Information Theory, Chapter 11: Hypothesis
Testing Asymptotics I . 现代补充阅读:Stein
指数及其换测度证明;此项不是历史起源断言。
建议的二次阅读顺序
先重新手算二项例子,再推一般指数族等式;最后读局部 Fisher 信息与 Stein
指数。
每次只问一个问题:此刻是在比较一次数据、取总体平均,还是优化一个模型?
This page was generated by DeepSeek 4.1 Flash from the course source; derivations and numbers are reproduced verbatim.
本页由 DeepSeek 4.1 Flash 依据课程讲义生成,推导与数值均按原讲义保留。