Chapter 6: GLM inference, goodness of fit and diagnostics

广义线性模型:推断、拟合优度与诊断

MTH303 Chapter 6 Companion Notes

GLM 的推断、拟合优度与诊断

详细推导、代码实验与练习解答

Inference, goodness of fit and diagnostics


本讲义对应指定的 MTH303_Chapter_6.pdf(37 页), 延续上一章的符号与讲解方式。前一章回答“怎样求出 𝜷̂\hat{\boldsymbol\beta}”; 这一章依次回答“估计有多不确定”“模型是否有用”“哪里可能拟合不对”。

贯穿全章的关系链
𝜷̂→η̂=X𝜷̂→μ̂=g−1(η̂)→Ŵ,I(𝜷̂).\hat{\boldsymbol\beta}\ \longrightarrow\ \hat\eta=X\hat{\boldsymbol\beta} \ \longrightarrow\ \hat\mu=g^{-1}(\hat\eta) \ \longrightarrow\ \hat W,\ I(\hat{\boldsymbol\beta}). I−1→标准误、Wald 检验;ℓ,D→LR、AIC、BIC.I^{-1}\ \longrightarrow\ \text{标准误、Wald 检验}; \qquad \ell, D\ \longrightarrow\ \text{LR、AIC、BIC}. (y,μ̂,Ŵ,X)→残差、杠杆、影响程度.(y,\hat\mu,\hat W,X)\ \longrightarrow\ \text{残差、杠杆、影响程度}. 同一个拟合结果会产生不同的检查工具;它们回答的问题并不完全相同。
原 PDF 页码 课件主题 本讲义展开的关键问题
4–9 MLE 的渐近性质 Taylor 展开、信息矩阵、子向量协方差
11–13 Wald 与 LR 单项、联合检验、自由度及两者联系
15–19 Adequacy checking 偏差、尺度、信息准则和伪 R2R^2
21–31 假设与残差 三种残差、离散随机化、怎样读图
32–34 异常点与共线性 IRLS 到帽子矩阵、Cook 距离与 VIF
36 模型选择 搜索策略、比较规则和验证流程
补充 代码与练习 Python 手写计算、R 核对、完整答案

怎样阅读

每一节先说明要解决的问题,再推导公式,最后说明它能支持什么结论。 建议先跟着单个系数、二维 Wald、Poisson 残差和 Cook 距离的手算走一遍, 再运行代码查看同一批数据上的所有诊断量。

对课件简写的必要补充 本文明确区分信息矩阵与协方差矩阵、渐近结论与精确结论; 补充离散分位数残差的随机化,以及 Cook 公式中尺度与杠杆分母的约定。 这些区别决定了公式怎样代入,不是额外的记忆负担。

先把符号与上一章接起来


emph对应原课件 PDF 第 4–9;回顾第 5 章 页 令 Y1,…,YnY_1,\ldots,Y_n 在给定设计矩阵 XX 后独立,且 fi(yi)=exp⁡{yiθi−b(θi)a+c(yi,ϕ)},a=a(ϕ)>0.f_i(y_i)=\exp\left\{\frac{y_i\theta_i-b(\theta_i)}{a} +c(y_i,\phi)\right\},\qquad a=a(\phi)>0. 本讲义先使用共同尺度 aa,不另加 offset 或 prior weights。 定义 k=p+1k=p+1 为包括截距的回归系数总数,XX 为 n×kn\times k 满列秩矩阵。 ηi=𝒙i𝖳𝜷=g(μi),μi=b′(θi),Vi=V(μi)=b″(θi),Var⁡(Yi)=aVi.\eta_i=\mathbf x_i^\mathsf T\boldsymbol\beta=g(\mu_i),\quad \mu_i=b'(\theta_i),\quad V_i=V(\mu_i)=b''(\theta_i), \quad \operatorname{Var}(Y_i)=aV_i. 沿用前章的 hh: θi=h(ηi)=(b′)−1{g−1(ηi)},hi′=1Vigi′,wi=1Vi(gi′)2,W=diag⁡(wi).\theta_i=h(\eta_i)=(b')^{-1}\{g^{-1}(\eta_i)\}, \quad h'_i=\frac1{V_i g'_i}, \quad w_i=\frac1{V_i(g'_i)^2},\quad W=\mathop{\mathrm{diag}}(w_i). 这里 hh 把 η\eta 变为 θ\theta,逆链接函数是 g−1g^{-1}。

估计、随机变量与真实值

𝜷0\boldsymbol\beta_0 表示未知但固定的真实参数;𝜷̂\hat{\boldsymbol\beta} 是数据决定的估计量。 重复抽样会改变 𝜷̂\hat{\boldsymbol\beta},也会改变 μ̂\hat\mu、残差和检验统计量。 公式中的 𝜷̂≈N(𝜷0,Σ)\hat{\boldsymbol\beta}\approx N(\boldsymbol\beta_0,\Sigma) 描述的是这种重复抽样分布。

三个矩阵不要混淆

U=∂ℓ∂𝜷,J=−∂2ℓ∂𝜷∂𝜷𝖳,I=𝔼(J)=1aX𝖳WX.U=\frac{\partial\ell}{\partial\boldsymbol\beta},\quad J=-\frac{\partial^2\ell}{\partial\boldsymbol\beta\partial\boldsymbol\beta^\mathsf T},\quad I=\mathbb E(J)=\frac1aX^\mathsf TWX. JJ 是观测信息,II 是 Fisher 信息;协方差约为 I−1I^{-1}。 后面用 HH 表示帽子矩阵,不再用它表示 Hessian。

维度检查是最便宜的防错方法
U,𝜷U,\boldsymbol\beta 是 k×1k\times1;I,J,Σ̂I,J,\hat{\Sigma} 是 k×kk\times k; W,HW,H 是 n×nn\times n。检验 qq 个独立限制时,Wald 中要求逆的是 q×qq\times q 的限制协方差。

为什么得分的均值为零,方差等于信息?


emph对应原课件 PDF 第 5–6 页

从整个样本的密度推导

记联合密度为 f(y;𝜷)f(y;\boldsymbol\beta),并假设可把求导移入积分、支持集不随参数改变。 因为 ∫f(y;𝜷)dy=1\int f(y;\boldsymbol\beta)\,dy=1, 𝔼(U)=∫∂log⁡f∂𝜷fdy=∫∂f∂𝜷dy=0.\mathbb E(U)=\int \frac{\partial\log f}{\partial\boldsymbol\beta}f\,dy =\int \frac{\partial f}{\partial\boldsymbol\beta}\,dy=0. 对任意分量 j,lj,l,二阶求导给出 ∂2f∂βj∂βl=f{∂2ℓ∂βj∂βl+∂ℓ∂βj∂ℓ∂βl}.\frac{\partial^2 f}{\partial\beta_j\partial\beta_l} =f\left\{\frac{\partial^2\ell}{\partial\beta_j\partial\beta_l} +\frac{\partial\ell}{\partial\beta_j} \frac{\partial\ell}{\partial\beta_l}\right\}. 再次积分,左侧为零,于是 Cov⁡(U)=𝔼(UU𝖳)=−𝔼(∇2ℓ)=I.{\operatorname{Cov}(U)=\mathbb E(UU^\mathsf T)=-\mathbb E(\nabla^2\ell)=I.} 这是后面把得分的随机波动转为参数估计误差的依据。

用 GLM 结构直接核对一次

U=1a∑i𝒙ihi′(Yi−μi),𝔼(U)=0.U=\frac1a\sum_i\mathbf x_i h'_i(Y_i-\mu_i),\qquad \mathbb E(U)=0. 独立性使不同观测的交叉协方差为零,因此 Cov⁡(U)=1a2∑i𝒙i𝒙i𝖳(hi′)2Var⁡(Yi)=1a∑i𝒙i𝒙i𝖳Vi(hi′)2=1a∑iwi𝒙i𝒙i𝖳=I.\begin{align*} \operatorname{Cov}(U) &=\frac1{a^2}\sum_i\mathbf x_i\mathbf x_i^\mathsf T(h'_i)^2\operatorname{Var}(Y_i)\\ &=\frac1a\sum_i\mathbf x_i\mathbf x_i^\mathsf TV_i(h'_i)^2 =\frac1a\sum_i w_i\mathbf x_i\mathbf x_i^\mathsf T=I. \end{align*} 其中 Vi(hi′)2=1/[Vi(gi′)2]=wiV_i(h'_i)^2=1/[V_i(g'_i)^2]=w_i。

先确认对哪个参数求导 课件先写单观测对 θ\theta 的得分 (Y−μ)/a(Y-\mu)/a,随后转到 𝜷\boldsymbol\beta。 对 𝜷\boldsymbol\beta 求导必须再乘 dθ/dηd\theta/d\eta 和 ∂η/∂𝜷=𝒙\partial\eta/\partial\boldsymbol\beta=\mathbf x, 不能直接把标量得分当作回归参数的得分向量。

从得分的 Taylor 展开到渐近正态


emph对应原课件 PDF 第 7–8 页 若 MLE 是内部解,则 U(𝜷̂)=0U(\hat{\boldsymbol\beta})=0。在真实参数 𝜷0\boldsymbol\beta_0 附近展开: 0=U(𝜷̂)≈U(𝜷0)−J(𝜷0)(𝜷̂−𝜷0).0=U(\hat{\boldsymbol\beta})\approx U(\boldsymbol\beta_0)-J(\boldsymbol\beta_0)(\hat{\boldsymbol\beta}-\boldsymbol\beta_0). 将误差项移到左边,得到 𝜷̂−𝜷0≈J(𝜷0)−1U(𝜷0)≈In(𝜷0)−1U(𝜷0).\hat{\boldsymbol\beta}-\boldsymbol\beta_0\approx J(\boldsymbol\beta_0)^{-1}U(\boldsymbol\beta_0) \approx I_n(\boldsymbol\beta_0)^{-1}U(\boldsymbol\beta_0). 第二个近似依赖大样本下观测曲率与期望曲率接近;它不是任意有限样本中的恒等式。

为什么会有 n\sqrt n?

信息是每个观测信息之和,通常为 nn 的量级。若 In/n→ℐ0>0,U(𝜷0)/n→dN(0,ℐ0),J(𝜷0)/n→pℐ0,I_n/n\longrightarrow\mathcal I_0>0, \qquad U(\boldsymbol\beta_0)/\sqrt n\xrightarrow{d}N(0,\mathcal I_0), \qquad J(\boldsymbol\beta_0)/n\xrightarrow{p}\mathcal I_0, 则由上式与 Slutsky 定理, n(𝜷̂−𝜷0)≈(J/n)−1Un→dN(0,ℐ0−1).\sqrt n(\hat{\boldsymbol\beta}-\boldsymbol\beta_0) \approx (J/n)^{-1}\frac{U}{\sqrt n} \xrightarrow{d}N(0,\mathcal I_0^{-1}). 常用简写就是 𝜷̂∼̇Nk(𝜷0,In(𝜷0)−1).{\hat{\boldsymbol\beta}\ \dot\sim\ N_k(\boldsymbol\beta_0,I_n(\boldsymbol\beta_0)^{-1}).} InI_n 已包含整个样本的信息,不要再把 In−1I_n^{-1} 除以 nn。 其协方差可直接核对: Cov⁡(In−1U)=In−1Cov⁡(U)In−1=In−1InIn−1=In−1.\operatorname{Cov}(I_n^{-1}U)=I_n^{-1}\operatorname{Cov}(U)I_n^{-1} =I_n^{-1}I_nI_n^{-1}=I_n^{-1}.

“渐近”并不等于“有限样本精确”

一致性、渐近正态与渐近有效性需要可识别性、足够信息、适当矩条件等。 正态近似本身不证明有限样本无偏;从分布收敛推出期望收敛还需要额外可积性条件。 边界参数、完全分离、秩缺陷或严重稀疏数据都可能破坏通常的推断。

与上一章 Newton 步的联系
Newton 用 J−1UJ^{-1}U 移动参数以求解;这里用同一个一阶关系解释 𝜷̂−𝜷0\hat{\boldsymbol\beta}-\boldsymbol\beta_0 的随机误差。优化公式与推断公式来自同一局部展开。

协方差、标准误与参数变换


emph对应原课件 PDF 第 4、8–9 页 真实参数未知,实际使用代入估计: Σ̂=I(𝜷̂,â)−1=â(X𝖳ŴX)−1,SE⁡(β̂j)=Σ̂jj.\hat{\Sigma}=I(\hat{\boldsymbol\beta},\hat a)^{-1} =\hat a(X^\mathsf T\hat W X)^{-1},\qquad \operatorname{SE}(\hat\beta_j)=\sqrt{\hat{\Sigma}_{jj}}. Poisson、二项模型的 a=1a=1;若估计共同尺度,应同时将它用于标准误。

协方差的非对角元有什么作用?

对于线性组合 t=c𝖳𝜷t=c^\mathsf T\boldsymbol\beta, t̂=c𝖳𝜷̂,Var̂(t̂)=c𝖳Σ̂c.\hat t=c^\mathsf T\hat{\boldsymbol\beta},\qquad \hat{\operatorname{Var}}(\hat t)=c^\mathsf T\hat{\Sigma} c. 例如 t=β1+β2t=\beta_1+\beta_2,其方差是 Σ̂11+Σ̂22+2Σ̂12\hat{\Sigma}_{11}+\hat{\Sigma}_{22}+2\hat{\Sigma}_{12}, 不能把协方差项遗漏。

Delta method:把系数变为有意义的量

对可微函数 t(𝜷)t(\boldsymbol\beta),一阶展开为 t(𝜷̂)−t(𝜷0)≈∇t(𝜷0)𝖳(𝜷̂−𝜷0),t(\hat{\boldsymbol\beta})-t(\boldsymbol\beta_0)\approx \nabla t(\boldsymbol\beta_0)^\mathsf T(\hat{\boldsymbol\beta}-\boldsymbol\beta_0), 所以 Var̂{t(𝜷̂)}≈∇t(𝜷̂)𝖳Σ̂∇t(𝜷̂).\hat{\operatorname{Var}}\{t(\hat{\boldsymbol\beta})\} \approx\nabla t(\hat{\boldsymbol\beta})^\mathsf T\hat{\Sigma}\nabla t(\hat{\boldsymbol\beta}). 在 Poisson-log 中,eβje^{\beta_j} 是其他变量保持不变时、xjx_j 增加一单位的均值比; 在 logistic 中,它是优势比。若 β̂j=0.6\hat\beta_j=0.6、SE 为 0.20.2, 则 e0.6=1.8221e^{0.6}=1.8221,delta 标准误约 1.8221(0.2)=0.36441.8221(0.2)=0.3644。

区间最好先在系数尺度上构造 先算 0.6±1.96(0.2)=[0.208,0.992]0.6\pm1.96(0.2)=[0.208,0.992],再取指数, 得到 [1.2312,2.6966][1.2312,2.6966]。这是单调变换区间,天然保持比值为正。 MLE 的不变性支持 eβ̂e^{\hat\beta} 作为变换参数的 MLE; 这不意味着有限样本 Wald 检验对所有非线性重新参数化都不变。

单个系数的 Wald 检验:一步一步做


emph对应原课件 PDF 第 11 页 检验 H0:βj=b0H_0:\beta_j=b_0 对 H1:βj≠b0H_1:\beta_j\ne b_0。在原假设下, β̂j−b0∼̇N(0,Σ̂jj),Z=β̂j−b0SE⁡(β̂j)∼̇N(0,1).\hat\beta_j-b_0\ \dot\sim\ N(0,\hat{\Sigma}_{jj}), \qquad Z=\frac{\hat\beta_j-b_0}{\operatorname{SE}(\hat\beta_j)} \ \dot\sim\ N(0,1). 双侧 pp 值和大样本 95%95\% 区间分别为 p=2{1−Φ(|Z|)},β̂j±1.96SE⁡(β̂j).p=2\{1-\Phi(|Z|)\},\qquad \hat\beta_j\pm1.96\operatorname{SE}(\hat\beta_j). 同一检验也可写成 W=Z2∼̇χ12W=Z^2\dot\sim\chi^2_1。因此文献中的“Wald statistic” 有时指带符号的 ZZ,有时指非负的 WW,必须看参考分布。

完整例子

某 Poisson-log 模型中,β̂1=0.6\hat\beta_1=0.6、SE 为 0.20.2,检验 β1=0\beta_1=0: Z=0.6/0.2=3,W=9,p=0.002700.Z=0.6/0.2=3,\quad W=9,\quad p=0.002700. 因为 |3|>1.96|3|>1.96,在 5%5\% 水平拒绝 H0H_0。在模型假设成立且其他协变量不变的意义下, 数据支持 x1x_1 与条件均值有关;它不是因果效应的自动证明。

解释效应大小与不确定性

仅报告“显著”会丢失信息。均值比为 1.82211.8221,近似置信区间为 [1.2312,2.6966][1.2312,2.6966],直接说明估计效应及其精度。

为什么不是总用线性回归的 tt 分布? 一般 GLM 的结论来自大样本正态近似,没有正态线性模型中那套精确独立卡方分解。 某些软件在估计尺度时使用带残差自由度的 t/Ft/F 近似;正态线性模型有更强的精确结果。 本章的已知尺度 Poisson 和二项例子使用 Z/χ2Z/\chi^2。

联合 Wald 检验与一般线性限制


emph对应原课件 PDF 第 9、12 页 把 qq 个独立限制写成 H0:R𝜷=rH_0:R\boldsymbol\beta=r,其中 RR 为满行秩的 q×kq\times k 矩阵。 由线性变换的正态性质, R𝜷̂−r∼̇Nq(0,RΣ̂R𝖳).R\hat{\boldsymbol\beta}-r\ \dot\sim\ N_q(0,R\hat{\Sigma} R^\mathsf T). 把相关、尺度不同的误差“白化”后平方求和,得到 W=(R𝜷̂−r)𝖳(RΣ̂R𝖳)−1(R𝜷̂−r)∼̇χq2.{W=(R\hat{\boldsymbol\beta}-r)^\mathsf T (R\hat{\Sigma} R^\mathsf T)^{-1}(R\hat{\boldsymbol\beta}-r) \ \dot\sim\ \chi^2_q.} 自由度等于独立限制数,不是总系数数,也不是样本量。

二维手算:协方差确实会改变统计量

设要检验两项同时为零,且 𝜷̂*=(0.40.3),S=(0.040.0120.0120.09).\hat{\boldsymbol\beta}_* =\begin{pmatrix}0.4\\0.3\end{pmatrix},\qquad S=\begin{pmatrix}0.04&0.012\\0.012&0.09\end{pmatrix}. det⁡S=0.003456,S−1=10.003456(0.09−0.012−0.0120.04),\det S=0.003456,\quad S^{-1}=\frac1{0.003456} \begin{pmatrix}0.09&-0.012\\-0.012&0.04\end{pmatrix}, W=0.09(0.4)2−2(0.012)(0.4)(0.3)+0.04(0.3)20.003456=4.375.W=\frac{0.09(0.4)^2-2(0.012)(0.4)(0.3)+0.04(0.3)^2} {0.003456}=4.375. χ22\chi^2_2 的右尾为 e−W/2e^{-W/2},所以 p=0.1122p=0.1122,在 5%5\% 水平不拒绝。 如果错误地忽略协方差,会得到 22+12=52^2+1^2=5。

联合检验不是把各项检验结果拼起来
联合原假设是所有限制同时成立;备择只要求至少一个不成立。 多个单项检验与一个联合检验具有不同拒绝域,也涉及不同的多重比较问题。

检验部分参数:先求逆,再取子矩阵


emph对应原课件 PDF 第 8–9、12;修正第 8 页的矩阵简写 页 把参数写成 𝜷=(α𝖳,γ𝖳)𝖳\boldsymbol\beta=(\alpha^\mathsf T,\gamma^\mathsf T)^\mathsf T,只检验 γ\gamma, 但 α\alpha 仍然要估计。把信息分块: I=(IααIαγIγαIγγ).I=\begin{pmatrix}I_{\alpha\alpha}&I_{\alpha\gamma}\\ I_{\gamma\alpha}&I_{\gamma\gamma}\end{pmatrix}. γ̂\hat\gamma 的渐近协方差是 I−1I^{-1} 中对应 γ\gamma 的子矩阵。 由分块求逆公式, Var⁡(γ̂)≈(Iγγ−IγαIαα−1Iαγ)−1.{\operatorname{Var}(\hat\gamma)\approx \left(I_{\gamma\gamma}-I_{\gamma\alpha} I_{\alpha\alpha}^{-1}I_{\alpha\gamma}\right)^{-1}.} 括号中减去的部分表示估计其余参数所损失的有效信息。 直接取 Iγγ−1I_{\gamma\gamma}^{-1} 相当于把其他参数当成已知,通常会低估不确定性。

最小的数值例子

I=(4225),I−1=116(5−2−24).I=\begin{pmatrix}4&2\\2&5\end{pmatrix},\qquad I^{-1}=\frac1{16}\begin{pmatrix}5&-2\\-2&4\end{pmatrix}. 第二个系数的方差为 4/16=0.254/16=0.25,也等于 (5−2⋅4−1⋅2)−1=1/4.(5-2\cdot4^{-1}\cdot2)^{-1}=1/4. 它不是 1/5=0.21/5=0.2。若 γ̂=1\hat\gamma=1,正确 Wald 为 12/0.25=41^2/0.25=4, 错误做法会得到 55。

实际代码怎么取?

先得到完整协方差 Σ̂\hat{\Sigma},再取所需行列; 或直接使用 RΣ̂R𝖳R\hat{\Sigma} R^\mathsf T。后者同时涵盖 “几个系数为零”和“两个系数相等”等检验。

课件第 8 页的关键阅读修正 子向量的方差应取 I−1I^{-1} 的子矩阵,不能取 II 的子矩阵。 信息越大,方差通常越小;二者的角色恰好相反。

Likelihood ratio:为什么要拟合两个模型?


emph对应原课件 PDF 第 13、17 页 设简化模型 M0M_0 嵌套于完整模型 M1M_1,参数数目为 k0<k1k_0<k_1。 在同一批数据上分别最大化似然,得到 ℓ̂0,ℓ̂1\hat\ell_0,\hat\ell_1。 因为 M0M_0 的允许参数集合包含在 M1M_1 内,ℓ̂1≥ℓ̂0\hat\ell_1\ge\hat\ell_0。 Λ=L0L1≤1,G2=−2log⁡Λ=2(ℓ̂1−ℓ̂0)≥0.\Lambda=\frac{L_0}{L_1}\le1,\qquad {G^2=-2\log\Lambda=2(\hat\ell_1-\hat\ell_0)\ge0.} 在内部参数、固定维数、可识别等正则条件下,原假设成立时 G2→dχq2,q=k1−k0.G^2\xrightarrow{d}\chi^2_q,\qquad q=k_1-k_0.

用偏差计算同一个量

若两个模型使用相同响应分布、同一饱和参照和共同固定尺度 aa, Dj=2a(ℓsat−ℓ̂j),D0−D1=2a(ℓ̂1−ℓ̂0),D_j=2a(\ell_{\mathrm{sat}}-\hat\ell_j), \quad D_0-D_1=2a(\hat\ell_1-\hat\ell_0), 故 G2=(D0−D1)/aG^2=(D_0-D_1)/a。Poisson 与二项 a=1a=1,就是偏差之差。

手算例子

若 ℓ̂0=−34\hat\ell_0=-34、ℓ̂1=−30\hat\ell_1=-30,新增一项系数,则 G2=2(−30+34)=8,q=1,p≈0.00468.G^2=2(-30+34)=8,\qquad q=1,\qquad p\approx0.00468. 在 5%5\% 水平拒绝简化模型。若新增两项,统计量仍为 88,但参考分布变为 χ22\chi^2_2,p=e−4=0.01832p=e^{-4}=0.01832。

每个模型里其余参数也要重新估计 完整模型中的某个系数设为零后,其他系数的最佳值通常会改变。 LR 用两个模型各自的最大似然,不能只把完整模型估计值的一部分硬改为零。 若尺度在各模型中分别估计,优先比较完整最大化对数似然; 不能随意用某个尺度把偏差差值相除。

例如正态模型在两模型中各自最大化未知 σ2\sigma^2 后,真正的 LR 是 G2=nlog⁡(RSS0/RSS1)G^2=n\log(\mathrm{RSS}_0/\mathrm{RSS}_1)。 而 {(RSS0−RSS1)/q}/{RSS1/(n−k1)}\{(\mathrm{RSS}_0-\mathrm{RSS}_1)/q\}/\{\mathrm{RSS}_1/(n-k_1)\} 是在正态假设下有精确 Fq,n−k1F_{q,n-k_1} 分布的另一个统计量。

Wald 与 LR 为什么大样本下接近?


emph对应原课件 PDF 第 7、9、11–13;推导补充 页 下面的渐近等价针对原假设或局部备择;不表示任意固定备择下两个统计量的数值都会趋于相同。 在完整模型 MLE 附近,似然近似为二次曲面: ℓ(𝜷)≈ℓ(𝜷̂)−12(𝜷−𝜷̂)𝖳I(𝜷̂)(𝜷−𝜷̂).\ell(\boldsymbol\beta)\approx\ell(\hat{\boldsymbol\beta}) -\frac12(\boldsymbol\beta-\hat{\boldsymbol\beta})^\mathsf TI(\hat{\boldsymbol\beta})(\boldsymbol\beta-\hat{\boldsymbol\beta}). 没有一次项,因为 U(𝜷̂)=0U(\hat{\boldsymbol\beta})=0。 对原假设 R𝜷=rR\boldsymbol\beta=r,受限 MLE 近似是在此曲面上最接近 𝜷̂\hat{\boldsymbol\beta} 的允许点。 令 d=𝜷−𝜷̂d=\boldsymbol\beta-\hat{\boldsymbol\beta},v=R𝜷̂−rv=R\hat{\boldsymbol\beta}-r,约束是 Rd=−vRd=-v。

用拉格朗日乘子解最小二次距离

最小化 dTId+2λT(Rd+v)d^TId+2\lambda^T(Rd+v),求导可得 Id+RTλ=0,d=−I−1RTλ,λ=(RI−1RT)−1v.Id+R^T\lambda=0,\quad d=-I^{-1}R^T\lambda, \quad \lambda=(RI^{-1}R^T)^{-1}v. 代回二次型: 2(ℓ̂1−ℓ̂0)≈dTId=vT(RI−1RT)−1v=W.2(\hat\ell_1-\hat\ell_0)\approx d^TId =v^T(RI^{-1}R^T)^{-1}v=W. 这解释了 Wald 和 LR 的渐近等价,而不只是说它们“都查卡方表”。

有限样本为什么不完全相同?

Wald 主要依赖完整模型处的局部曲率;LR 真正比较两个最优似然高度。 当似然明显不对称、参数靠近边界或估计很不稳定时,二次近似可能较差。 同一个数据集上两种 pp 值有差异并不意味着程序错误。

检验的三个成分必须一起报告
写清原假设、统计量以及参考分布/自由度,再报告 pp 值与结论。 “统计量很大”本身不足以确定显著性;不同自由度和不同尺度有不同参照。

残差偏差能直接查 χn−k2\chi^2_{n-k} 吗?


emph对应原课件 PDF 第 16–17 页 拟合模型相对饱和模型的 scaled deviance 为 D*=2(ℓsat−ℓ̂)=D/a.D^*=2(\ell_{\mathrm{sat}}-\hat\ell)=D/a. 如果每个观测均值可单独估计,饱和均值模型有 nn 个参数,所以形式上的自由度差为 n−kn-k。 课件据此写 D/a≈χn−k2D/a\approx\chi^2_{n-k},但这个近似需要额外条件。

为什么不能直接套上节的 Wilks 结论?

通常 Wilks 定理比较两个固定维数模型;这里饱和模型的维数随着 nn 增长。 因此仅仅有很多观测,并不自动保证残差偏差的卡方近似准确。 较大 Poisson 均值、组内有足够信息的 grouped binomial,常使这种近似更合理。

Bernoulli 的简单反例

若真实成功率 π=1/2\pi=1/2,每个响应只取 0,10,1。在真实均值处,每个偏差贡献都是 di=−2log⁡(1/2)=2log⁡2=1.38629,D=2nlog⁡2.d_i=-2\log(1/2)=2\log2=1.38629, \quad D=2n\log2. 而 χn−k2\chi^2_{n-k} 的均值约为 nn。即使 nn 很大,这个差距也不会消失。 估计少数回归参数不改变这一主导量级结论。

什么时候有精确结果?

正态线性模型中,D=RSSD=\mathrm{RSS},已知真实 a=σ2a=\sigma^2 时 RSS/σ2∼χn−k2\mathrm{RSS}/\sigma^2\sim\chi^2_{n-k} 是精确结论,来自正态误差的正交投影。

两个“偏差检验”要分开 固定维数嵌套模型的偏差差值常可使用 Wilks 近似; 一个模型的总残差偏差对饱和模型的检验,条件更严格。 前者可用不代表后者也必然可用。

尺度与过度离散:D/(n−k)D/(n-k) 在估计什么?


emph对应原课件 PDF 第 16、22、25 页 共同尺度模型为 Var⁡(Yi)=aV(μi)\operatorname{Var}(Y_i)=aV(\mu_i)。常见估计量有 âD=Dn−k,âP=XP2n−k,XP2=∑i(yi−μ̂i)2V(μ̂i).\hat a_D=\frac{D}{n-k},\qquad \hat a_P=\frac{X_P^2}{n-k},\qquad X_P^2=\sum_i\frac{(y_i-\hat\mu_i)^2}{V(\hat\mu_i)}. XP2X_P^2 是 Pearson 统计量,不是设计矩阵 XX 的平方。

为什么分母是残差自由度?

局部线性近似下,拟合参数消耗了 kk 个方向。 后文将推出 Var⁡(rPi)≈a(1−hii)\operatorname{Var}(r_{Pi})\approx a(1-h_{ii}),因而 𝔼(XP2)≈a∑i(1−hii)=a(n−k).\mathbb E(X_P^2)\approx a\sum_i(1-h_{ii})=a(n-k). 这给出 Pearson 尺度估计。若偏差残差与 Pearson 残差局部接近, D/(n−k)D/(n-k) 也可能合理;二者并非对所有响应分布都同样准确。

Poisson 模型为何仍会查看这个比值?

Poisson 分布本身规定 a=1a=1。若 XP2/(n−k)X_P^2/(n-k) 明显大于 11, 可能是遗漏均值结构、个体异质性、相关性或响应分布过窄。 先查残差趋势与数据结构,再考虑 quasi-Poisson、负二项等扩展。 把标准误乘上 â\sqrt{\hat a} 只能调整某类方差错误,不能修正错误的均值函数。

两个边界 单个 Bernoulli 变量满足 Var⁡(Y)=π(1−π)\operatorname{Var}(Y)=\pi(1-\pi),不能简单在保持 Bernoulli 边际分布时另加自由尺度。 组内相关的二项数据是另一种问题。 此外 quasi-likelihood 不是完整概率似然,不能把其结果直接代入普通 likelihood AIC 或 LR。

AIC 与 BIC:奖励拟合,也惩罚参数


emph对应原课件 PDF 第 15、18 页 扩大模型通常提高训练数据上的最大似然,因此不能只挑最大似然最高的模型。 令 KK 为在似然中实际估计的自由参数总数: AIC=−2ℓ̂+2K,BIC=−2ℓ̂+Klog⁡n.{\mathrm{AIC}=-2\hat\ell+2K,\qquad \mathrm{BIC}=-2\hat\ell+K\log n.} 二者均取较小者。AIC 是对预测损失偏差校正思想的近似; BIC 在其正则条件下可从边际似然的大样本近似得到。 本章侧重如何正确计算与解释,不把二者当作拟合充分性的证明。

为什么这里用 KK,前面用 kk?

已知尺度的 Poisson、二项模型通常 K=kK=k。 正态模型若估计 σ2\sigma^2,应计入该参数,故 K=k+1K=k+1。 负二项若同时估计离散参数,也要计入。课件的 p+1p+1 对应尺度固定的情形。

同一个似然改善何时足以保留变量?

若新增 qq 个参数且 G2=2(ℓ̂1−ℓ̂0)G^2=2(\hat\ell_1-\hat\ell_0), AIC1−AIC0=−G2+2q,BIC1−BIC0=−G2+qlog⁡n.\mathrm{AIC}_1-\mathrm{AIC}_0=-G^2+2q, \quad \mathrm{BIC}_1-\mathrm{BIC}_0=-G^2+q\log n. 所以 AIC 倾向完整模型当 G2>2qG^2>2q,BIC 则要求 G2>qlog⁡nG^2>q\log n。 这不是统一的 5%5\% 显著性检验。

小例子

取 n=100n=100,(ℓ̂0,K0)=(−120,2)(\hat\ell_0,K_0)=(-120,2)、(ℓ̂1,K1)=(−118,3)(\hat\ell_1,K_1)=(-118,3)。 AIC0=244,AIC1=242;BIC0=249.2103,BIC1=249.8155.\mathrm{AIC}_0=244,\quad \mathrm{AIC}_1=242; \qquad \mathrm{BIC}_0=249.2103,\quad \mathrm{BIC}_1=249.8155. AIC 选完整模型,BIC 选简化模型,因为二者的复杂度惩罚不同。

比较前确认数据与似然口径相同 比较同一响应、同一观测集合、可比基准测度下的完整似然。 因缺失值而使用不同样本、随意丢掉不同的似然常数、直接比较变换前后响应的似然, 都会使数值比较失去原来的意义。非嵌套模型可比较合适的 AIC/BIC,但普通嵌套 LR 不适用。

课件的 pseudo-R2R^2 就是偏差解释比例


emph对应原课件 PDF 第 19 页 课件定义 RD2=ℓ̂−ℓnullℓsat−ℓnull.R_D^2=\frac{\hat\ell-\ell_{\mathrm{null}}} {\ell_{\mathrm{sat}}-\ell_{\mathrm{null}}}. 在同一尺度和饱和参照下,把分子写成两个偏差之差: ℓ̂−ℓnull=(ℓsat−ℓnull)−(ℓsat−ℓ̂),\hat\ell-\ell_{\mathrm{null}} =(\ell_{\mathrm{sat}}-\ell_{\mathrm{null}}) -(\ell_{\mathrm{sat}}-\hat\ell), 从而 RD2=1−DDnull.{R_D^2=1-\frac{D}{D_{\mathrm{null}}}.} 若模型包含截距零模型、都充分最大化同一似然且 Dnull>0D_{\mathrm{null}}>0, 则 0≤D≤Dnull0\le D\le D_{\mathrm{null}},所以 0≤RD2≤10\le R_D^2\le1。 若比较的是任意给定预测、模型不包含零模型或优化未收敛,这个范围不再有相同保证。

与普通 R2R^2 的关系

正态 identity 模型中 D=RSSD=\mathrm{RSS}、Dnull=SSTD_{\mathrm{null}}=\mathrm{SST}, 故回到 1−RSS/SST1-\mathrm{RSS}/\mathrm{SST}。 一般 GLM 中解释的是相对零模型的偏差降低比例,不是响应方差的普通分解。

与其他叫作 pseudo-R2R^2 的量区分

McFadden 的定义为 1−ℓ̂/ℓnull1-\hat\ell/\ell_{\mathrm{null}}。 个体 Bernoulli 数据的饱和对数似然为零,两种定义相同; 一般 Poisson 或 grouped binomial 数据并不相同。 因此报告数值时应注明公式。

一个数值只回答一个问题
若 Dnull=80,D=32D_{\mathrm{null}}=80,D=32,则 RD2=0.6R_D^2=0.6,表示相对零模型消除了 60%60\% 的偏差。它不证明响应分布正确、观测独立,也不保证样本外预测良好。

诊断究竟在检查哪一层假设?


emph对应原课件 PDF 第 21–23 页 回归模型描述的是给定解释变量之后的响应分布。写成 Yi∣𝒙i∼指定的分布族,𝔼(Yi∣𝒙i)=μi,g(μi)=ηi=𝒙i𝖳𝜷,Y_i\mid\mathbf x_i\sim\text{指定的分布族},\qquad \mathbb E(Y_i\mid\mathbf x_i)=\mu_i,\qquad g(\mu_i)=\eta_i=\mathbf x_i^\mathsf T\boldsymbol\beta, 并假定在所用模型下,各个响应条件独立。因此,诊断至少要分清以下三个问题。

  1. 均值是否写对? 解释变量、非线性项、交互作用及链接函数共同决定 μi\mu_i。遗漏 xi2x_i^2 可能使残差随 xix_i 弯曲。

  2. 均值之外的分布是否合适? 即使均值接近真实值,方差、零值概率、偏斜程度仍可能写错。

  3. 观测之间是否独立? 同一受试者的重复测量、相邻时间点或同一群组内的数据可能相关。

链接与分布分别控制什么?

例子 均值模型 条件方差或结构
正态 + identity μi=ηi\mu_i=\eta_i Var⁡(Yi∣𝒙i)=σ2\operatorname{Var}(Y_i\mid\mathbf x_i)=\sigma^2
Poisson + log μi=eηi\mu_i=e^{\eta_i} Var⁡(Yi∣𝒙i)=μi\operatorname{Var}(Y_i\mid\mathbf x_i)=\mu_i
Bernoulli + logit pi=expit⁡(ηi)p_i=\mathop{\mathrm{expit}}(\eta_i) Var⁡(Yi∣𝒙i)=pi(1−pi)\operatorname{Var}(Y_i\mid\mathbf x_i)=p_i(1-p_i)
Bernoulli + probit pi=Φ(ηi)p_i=\Phi(\eta_i) 方差仍为 pi(1−pi)p_i(1-p_i)

例如,logit 改成 probit 改的是 η↦p\eta\mapsto p 的关系;两者都仍假定条件响应是 Bernoulli。 对于有额外变异的计数数据,负二项模型可作为候选,但要先检查均值结构和数据依赖。

GLM 的“线性”位于线性预测子上
log⁡μi=β0+β1xi+β2xi2\log\mu_i=\beta_0+\beta_1x_i+\beta_2x_i^2 对 xix_i 有曲率,但对系数仍然线性,仍是 GLM。 不要求 μi\mu_i 本身是 xix_i 的直线,也不要求所有 YiY_i 的边际分布相同。

原始残差 yi−μ̂iy_i-\hat\mu_i 的大小还受到方差尺度影响。Poisson 均值较大时,正常的随机波动本来就较大;直接比较原始残差会把这一点混入诊断。

Pearson 残差:先把局部方差除掉


emph对应原课件 PDF 第 24–26、31 页 本讲义沿用课件的记法 Var⁡(Yi∣𝒙i)=aV(μi),a=a(ϕ)>0,\operatorname{Var}(Y_i\mid\mathbf x_i)=aV(\mu_i),\qquad a=a(\phi)>0, 其中 aa 是共同尺度,V(μ)V(\mu) 是方差函数。课件定义的 Pearson 残差不包含 aa: rPi=yi−μ̂iV(μ̂i).{r_{Pi}=\frac{y_i-\hat\mu_i}{\sqrt{V(\hat\mu_i)}}.} 例如 Poisson 中 V(μ)=μV(\mu)=\mu,Bernoulli 中 V(p)=p(1−p)V(p)=p(1-p),正态中 V(μ)=1V(\mu)=1。

为什么这个分母合理?先假定参数已知

为避免把“真实均值”和“估计均值”混在一起,先定义 RPitrue=Yi−μiV(μi).R_{Pi}^{\mathrm{true}}=\frac{Y_i-\mu_i}{\sqrt{V(\mu_i)}}. 由于此时分母是给定设计下的常数, 𝔼(RPitrue)=0,Var⁡(RPitrue)=aV(μi)V(μi)=a.\mathbb E(R_{Pi}^{\mathrm{true}})=0,\qquad \operatorname{Var}(R_{Pi}^{\mathrm{true}}) =\frac{aV(\mu_i)}{V(\mu_i)}=a. 因此 RPitrue/aR_{Pi}^{\mathrm{true}}/\sqrt a 的方差为 1。这只说明均值和方差,尚未证明正态分布;离散响应仍然产生离散残差。

用同一份数据拟合之后,还要考虑杠杆

μ̂i\hat\mu_i 是数据计算出来的,拟合会吸收部分随机波动。局部线性近似给出 Var⁡(rPi)≈a(1−hii),\operatorname{Var}(r_{Pi})\approx a(1-h_{ii}), 其中 hiih_{ii} 是后文推导的 GLM 工作帽子矩阵对角元。于是常用的标准化 Pearson 残差为 rPistd=rPiâ(1−hii).{r_{Pi}^{\mathrm{std}}= \frac{r_{Pi}}{\sqrt{\hat a(1-h_{ii})}}.} Poisson 和普通二项模型通常取 a=1a=1;未知尺度时需说明采用哪一个估计,例如 Pearson 估计 âP=∑irPi2n−k,k=回归系数个数(包括截距).\hat a_P=\frac{\sum_i r_{Pi}^2}{n-k},\qquad k=\text{回归系数个数(包括截距)}.

不要混用三个量 rPr_P、rP/ar_P/\sqrt a、rP/a(1−h)r_P/\sqrt{a(1-h)} 是不同的残差定义。引用公式或比较软件输出时,先看是否已经除过尺度和杠杆修正。

Deviance 残差:把总偏差分配到每个点


emph对应原课件 PDF 第 24、27 页 独立观测的对数似然可相加,因此在共同尺度下,未缩放偏差也可以写为 D=∑i=1ndi,di=2[yi(θ̃i−θ̂i)−b(θ̃i)+b(θ̂i)]≥0.D=\sum_{i=1}^n d_i,\qquad d_i=2\left[y_i(\widetilde\theta_i-\hat\theta_i) -b(\widetilde\theta_i)+b(\hat\theta_i)\right]\geq0. did_i 衡量第 ii 个观测在拟合均值和饱和均值之间的似然损失。因为 did_i 没有方向信息,取平方根后再补上原始残差的符号: rDi=sign⁡(yi−μ̂i)di,∑irDi2=D.{r_{Di}=\mathop{\mathrm{sign}}(y_i-\hat\mu_i)\sqrt{d_i}},\qquad {\sum_i r_{Di}^2=D.} 这与普通最小二乘中 ∑i(yi−ŷi)2=RSS\sum_i(y_i-\hat y_i)^2=\mathrm{RSS} 的结构对应。

Poisson:把 θ=log⁡μ,b(θ)=eθ\theta=\log\mu,\ b(\theta)=e^\theta 代入

若 yi>0y_i>0,饱和均值为 yiy_i,于是 di=2{yi(log⁡yi−log⁡μ̂i)−yi+μ̂i}=2{yilogyiμ̂i−(yi−μ̂i)}.\begin{align*} d_i &=2\{y_i(\log y_i-\log\hat\mu_i)-y_i+\hat\mu_i\}\\ &=2\left\{y_i\log\frac{y_i}{\hat\mu_i}-(y_i-\hat\mu_i)\right\}. \end{align*} 若 yi=0y_i=0,使用 lim⁡t↓0tlog⁡t=0\lim_{t\downarrow0}t\log t=0,得到 di=2μ̂id_i=2\hat\mu_i。

同样预测为 2,两个观测逐项计算

yiy_i μ̂i\hat\mu_i did_i rDir_{Di} rPir_{Pi}
0 2 44 −2-2 −2≈−1.4142-\sqrt2\approx-1.4142
4 2 2(4log⁡2−2)≈1.54522(4\log2-2)\approx1.5452 1.24311.2431 2≈1.4142\sqrt2\approx1.4142

两者的原始残差都是大小为 2,Pearson 残差大小也相同;但偏差残差大小不同,因为 Poisson 分布的似然形状并不关于均值对称。

正态模型为何恢复原始残差?
正态模型有 di=(yi−μ̂i)2d_i=(y_i-\hat\mu_i)^2,因此 rDi=yi−μ̂ir_{Di}=y_i-\hat\mu_i。共同尺度是 a=σ2a=\sigma^2,所以 D/a=RSS/σ2D/a=\mathrm{RSS}/\sigma^2。

二项残差:计数与单次 Bernoulli 要分清


emph对应原课件 PDF 第 24、26–27、30–31 页 若 Yi∼Binomial⁡(mi,pi)Y_i\sim\operatorname{Binomial}(m_i,p_i),先以成功次数为响应,记 μi=mipi\mu_i=m_ip_i。饱和成功率为 yi/miy_i/m_i,从二项对数似然相减得到 di=2[yilogyimip̂i+(mi−yi)logmi−yimi(1−p̂i)],d_i=2\left[ y_i\log\frac{y_i}{m_i\hat p_i} +(m_i-y_i)\log\frac{m_i-y_i}{m_i(1-\hat p_i)} \right], 其中 0log⁡00\log0 按连续极限解释为 0。对应的 Pearson 残差是 rPi=yi−mip̂imip̂i(1−p̂i).r_{Pi}=\frac{y_i-m_i\hat p_i}{\sqrt{m_i\hat p_i(1-\hat p_i)}}. 若软件用成功比例 yi/miy_i/m_i 建模,必须同时提供试验次数权重;不能只更换响应尺度而丢掉 mim_i。

单次 Bernoulli:令 mi=1m_i=1

此时 yiy_i 只能是 0 或 1, rDi={−−2log⁡(1−p̂i),yi=0,−−2log⁡p̂i,yi=1.r_{Di}=\begin{cases} -\sqrt{-2\log(1-\hat p_i)},&y_i=0,\\[2pt] \phantom{-}\sqrt{-2\log\hat p_i},&y_i=1. \end{cases} 令真实成功率已知且为 p=0.3p=0.3。在模型完全正确时仍然只有两种可能: RD={−0.844600,概率 0.7,−1.551756,概率 0.3.R_D=\begin{cases} -0.844600,&\text{概率 }0.7,\\ \phantom{-}1.551756,&\text{概率 }0.3. \end{cases} 不仅它不是正态,而且 𝔼(RD)=0.7(−0.844600)+0.3(1.551756)≈−0.125694≠0.\mathbb E(R_D)=0.7(-0.844600)+0.3(1.551756)\approx-0.125694\ne0.

样本数变大,不会把每一个 Bernoulli 变成正态 增加独立的 Bernoulli 观测个数,会改善系数估计的渐近近似,但单个响应仍只有两个值。 “MLE 渐近正态”不推出“每个 Pearson/Deviance 残差都渐近正态”。 分组试验次数 mim_i 变大,与单次观测的个数 nn 变大,是不同的极限。

为什么 Pearson 与 Deviance 常常接近?


emph对应原课件 PDF 第 27、31;补充二阶展开 页 固定预测均值 μ\mu,把单点偏差视为观测值 tt 的函数: d(t;μ)=2{t[θ(t)−θ(μ)]−b(θ(t))+b(θ(μ))}.d(t;\mu)=2\{t[\theta(t)-\theta(\mu)]-b(\theta(t))+b(\theta(\mu))\}. 这里 θ(t)=(b′)−1(t)\theta(t)=(b')^{-1}(t) 表示“若均值为 tt,对应的典则参数”。在均值空间内部作光滑延拓,由参数链 b′(θ(t))=t,θ′(t)=1b″(θ(t))=1V(t).b'(\theta(t))=t,\qquad \theta'(t)=\frac{1}{b''(\theta(t))}=\frac{1}{V(t)}.

第 1 步:求一阶导,观察抵消

∂d(t;μ)∂t=2{θ(t)−θ(μ)+tθ′(t)−b′(θ(t))θ′(t)}=2{θ(t)−θ(μ)}.\begin{align*} \frac{\partial d(t;\mu)}{\partial t} &=2\{\theta(t)-\theta(\mu)+t\theta'(t) -b'(\theta(t))\theta'(t)\}\\ &=2\{\theta(t)-\theta(\mu)\}. \end{align*} 因此 d(μ;μ)=0d(\mu;\mu)=0,且一阶导在 t=μt=\mu 处也是 0。

第 2 步:求二阶导,再在 t=μt=\mu 展开

∂2d(t;μ)∂t2=2θ′(t)=2V(t).\frac{\partial^2 d(t;\mu)}{\partial t^2}=2\theta'(t)=\frac{2}{V(t)}. 所以当 yy 接近 μ\mu,且更高阶项较小时, d(y;μ)≈0+0(y−μ)+122V(μ)(y−μ)2=(y−μ)2V(μ).d(y;\mu)\approx0+0\,(y-\mu) +\frac12\frac{2}{V(\mu)}(y-\mu)^2 =\frac{(y-\mu)^2}{V(\mu)}. 补回符号便得到 rD≈y−μV(μ)=rP.{r_D\approx\frac{y-\mu}{\sqrt{V(\mu)}}=r_P.}

这是局部近似,决定因素是单个观测的分布形状
当正态近似合理、观测离均值不太远时,两种残差往往相似。正态族中上式精确成立。 均值很小的 Poisson、稀少成功事件或单次 Bernoulli 情形,局部二阶近似可能很粗糙。

因此,D/aD/a 的某种卡方近似不能单独作为“所有 rDir_{Di} 都独立正态”的证明;平方和的近似分布不决定每个分量的分布。

连续响应的分位数残差:PIT 推导


emph对应原课件 PDF 第 24、26、31 页 分位数残差从整个条件分布出发,而不只使用均值和方差。先假定参数已知,且条件 CDF FiF_i 连续并严格递增,定义 Ui=Fi(Yi),RQi=Φ−1(Ui),U_i=F_i(Y_i),\qquad R_{Qi}=\Phi^{-1}(U_i), 其中 Φ\Phi 是标准正态 CDF。

第 1 步:概率积分变换(PIT)把响应转成均匀分布

对任意 0<u<10<u<1,单调性给出 Pr⁡(Ui≤u)=Pr⁡(Fi(Yi)≤u)=Pr⁡(Yi≤Fi−1(u))=Fi(Fi−1(u))=u.\begin{align*} \Pr(U_i\leq u) &=\Pr(F_i(Y_i)\leq u)\\ &=\Pr(Y_i\leq F_i^{-1}(u))\\ &=F_i(F_i^{-1}(u))=u. \end{align*} 这恰是 Uniform⁡(0,1)\operatorname{Uniform}(0,1) 的 CDF。因此 Ui∼Uniform⁡(0,1)U_i\sim\operatorname{Uniform}(0,1)。

第 2 步:用正态分位数函数转成标准正态

对任意实数 zz, Pr⁡(RQi≤z)=Pr⁡{Ui≤Φ(z)}=Φ(z),\Pr(R_{Qi}\leq z) =\Pr\{U_i\leq\Phi(z)\} =\Phi(z), 故 RQi∼N(0,1)R_{Qi}\sim N(0,1)。如果原始响应独立,这些由各自响应作出的变换也独立。

实际诊断中,哪里发生了近似?

通常我们不知道真实 CDF,只能使用同一批数据估计出的 F̂i(y)=F(y;μ̂i,ϕ̂),rQi=Φ−1{F̂i(yi)}.\hat F_i(y)=F(y;\hat\mu_i,\hat\phi),\qquad r_{Qi}=\Phi^{-1}\{\hat F_i(y_i)\}. 此时 F̂i\hat F_i 本身随机,并且依赖 YiY_i 及其他观测。 前面的推导不能直接把 F̂i(F̂i−1(u))=u\hat F_i(\hat F_i^{-1}(u))=u 当成对真实抽样概率的证明。

“精确正态”的正确范围 连续响应、真实分布正确且参数已知时,PIT 给出精确结果。 用估计参数构造的残差通常只有近似性质,还带有拟合引入的依赖。 需要更准确的基准时,可模拟并重新拟合模型,构造诊断包络。

离散响应:为什么必须随机化?


emph对应原课件 PDF 第 24、26、31;补充离散型修正 页 离散 CDF 有跳跃。若 Y∼Bernoulli⁡(0.3)Y\sim\operatorname{Bernoulli}(0.3),则 F(Y)F(Y) 只可能是 0.70.7 或 11,既不均匀,还会使 Φ−1(1)=+∞\Phi^{-1}(1)=+\infty。因此不能直接套用连续型公式。

在每一个概率质量对应的区间内均匀抽取

记 F(y−)=Pr⁡(Y<y)F(y^-)=\Pr(Y<y),独立生成 V∼Uniform⁡(0,1)V\sim\operatorname{Uniform}(0,1),定义 U=F(Y−)+V{F(Y)−F(Y−)},RQ=Φ−1(U).{U=F(Y^-)+V\{F(Y)-F(Y^-)\}},\qquad {R_Q=\Phi^{-1}(U)}. 整数计数中 F(y−)=F(y−1)F(y^-)=F(y-1)。区间长度 F(y)−F(y−)=Pr⁡(Y=y)F(y)-F(y^-)=\Pr(Y=y) 正好就是该观测值的概率质量。

为什么这种随机化恢复均匀分布?

给定 uu 位于某一个跳跃区间 [a,b]=[F(y−),F(y)][a,b]=[F(y^-),F(y)]。在此区间之前的取值共有概率 aa;取到当前 yy 的概率是 b−ab-a,且给定 Y=yY=y 后,UU 在 [a,b][a,b] 上均匀。因此 Pr⁡(U≤u)=a+(b−a)u−ab−a=u.\Pr(U\leq u) =a+(b-a)\frac{u-a}{b-a}=u. 所有跳跃区间拼接覆盖 (0,1)(0,1),故 UU 均匀;再应用上一节的第二步,得到 RQ∼N(0,1)R_Q\sim N(0,1)。

Bernoulli p=0.3p=0.3:把区间写出来

观测 概率 随机化区间 若示例取 V=0.5V=0.5 Φ−1(U)\Phi^{-1}(U)
y=0y=0 0.70.7 (0,0.7)(0,0.7) U=0.35U=0.35 −0.385320-0.385320
y=1y=1 0.30.3 (0.7,1)(0.7,1) U=0.85U=0.85 1.0364331.036433

表中固定 V=0.5V=0.5 只是演示公式;实际随机化必须为每个观测独立抽取 ViV_i。总取中点的 mid-P 残差不具有上述精确均匀性质。

参数估计与随机种子都要说明 精确结论仍要求使用真实 CDF。实际代入 μ̂,ϕ̂\hat\mu,\hat\phi 后是近似诊断;固定随机种子是为了复现,不能挑选“最像正态”的某一次随机化来报告。

图例:正确的 Bernoulli 模型也会有弯曲 Q–Q 图


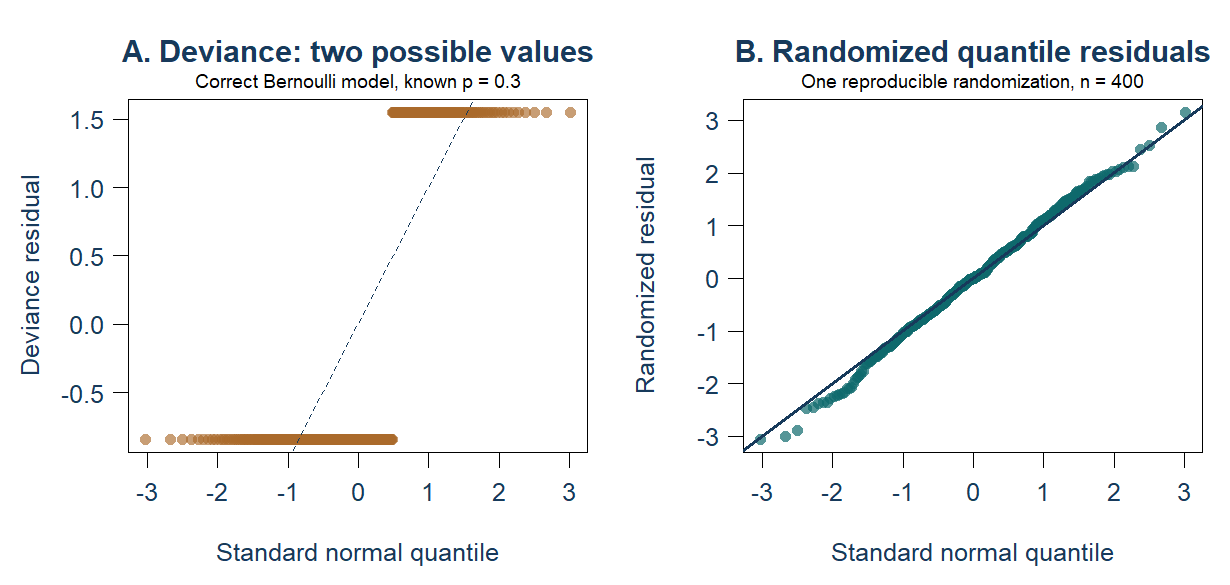
emph对应原课件 PDF 第 26、30–31;配套模拟例子 页 下图由 companion.R 生成:独立模拟 400 个 Bernoulli 响应,真实成功率 p=0.3p=0.3,并使用已知的真实参数计算残差。

quantile_qq.png
图:分位残差图(左)与正态 QQ 图(右)。左图两条水平带是响应只取两个值的直接后果,说明残差分布不可能近似正态。

左图:两条水平带是响应只有两个值的直接后果

每个偏差残差只能是 −0.844600-0.844600 或 1.5517561.551756。排序后,大约前 70% 的点停留在第一条水平带,后 30% 停留在第二条水平带。 它们不可能沿正态分位数参考直线排列。这里模型已知是正确的,所以这幅图不能被解读为“Bernoulli 分布假设被否定”。

右图:随机化填平了离散 CDF 的跳跃

y=0y=0 对应的概率质量被分配在 (0,0.7)(0,0.7),y=1y=1 对应的概率质量被分配在 (0.7,1)(0.7,1)。再经 Φ−1\Phi^{-1} 变换,残差在标准正态尺度上连续展开。 有限样本仍有随机偏离,点不需要完美地落在直线上。

读图顺序:先考虑残差的理论形状,再判断异常
先问响应是连续还是离散、残差是哪一种、参数是否估计,再问图中的偏离是否超出该模型本来会产生的程度。 对于稀疏计数或单次 Bernoulli,随机分位数残差通常更容易与正态基准比较;Pearson 残差仍可用于检查均值、方差和影响程度。

图中使用 R 随机种子 6027;逐点数据保存在 results_r/bernoulli_known_p.csv。

残差图怎么读:横轴决定你能看见什么


emph对应原课件 PDF 第 28–31 页 “画残差图”还不够,要说明残差类型、横轴和比较基准。下面几种图回答的问题不同。

图形 主要寻找什么 解释时的限制
rDr_D 对 η̂\hat\eta 均值结构的趋势、曲率 离散响应可自然形成条带
rPstdr_P^{\mathrm{std}} 对 μ̂\hat\mu 波动大小是否随均值变化 均值错误也可能制造“大方差”
残差对某个 xjx_j 被遗漏的非线性项、局部结构 与其他变量相关时要联合判断
随机分位数 Q–Q 条件分布与尾部是否协调 拟合参数、随机化都影响基准
残差对时间或顺序 连续同号、周期、群组变化 需要有实际意义的顺序

为什么还要画残差对每个解释变量?

η̂i=𝒙i𝖳𝜷̂\hat\eta_i=\mathbf x_i^\mathsf T\hat{\boldsymbol\beta} 把多个变量压成一个数。某个变量的曲率可能在这个投影中不明显。 若怀疑 xx 的效应并非线性,可以比较 M0:g(μi)=β0+β1xi,M1:g(μi)=β0+β1xi+β2xi2.M_0:\quad g(\mu_i)=\beta_0+\beta_1x_i, \qquad M_1:\quad g(\mu_i)=\beta_0+\beta_1x_i+\beta_2x_i^2. 然后结合残差图、二次项检验和模型比较。仅有一条平滑线偏离零,不能自动确定原因一定是链接函数错误。

“无明显趋势”不等于“模型已经证明正确”

图形对某些偏离较敏感,对另一些偏离可能没有足够分辨力。弱非线性、小样本、极少的响应取值都会使判断困难。 可在拟合模型下模拟响应、重新拟合并重新作图,观察原图相对于这些模拟图是否异常。

不要为了让响应正态而机械地变换计数或二元值 GLM 本来就允许非正态响应。先检查均值项、链接、分布、尺度和依赖;对 YY 作变换会改变模型目标和响应支持集,需要重新说明分布假设。

接下来用一份已知生成机制的模拟数据,观察遗漏均值曲率怎样同时影响残差图与“离散程度”统计量。

图例:遗漏均值曲率,看起来也会“过度离散”


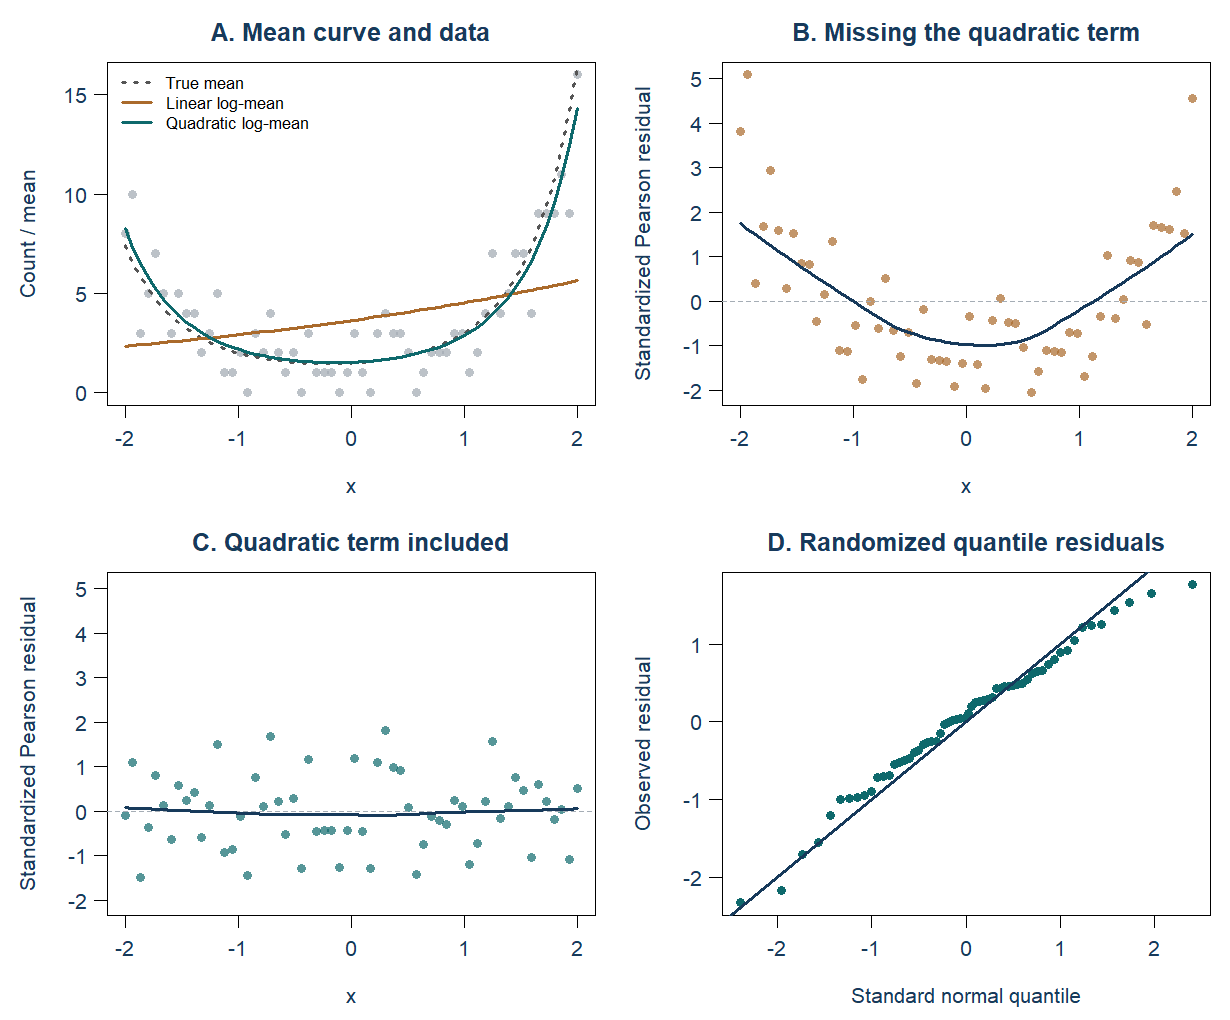
emph对应原课件 PDF 第 28–31;配套 Poisson 模拟例子 页 使用 60 个固定的 xi∈[−2,2]x_i\in[-2,2],独立生成 Yi∼Poisson⁡(μi),log⁡μi=0.4+0.2xi+0.5xi2.Y_i\sim\operatorname{Poisson}(\mu_i),\qquad \log\mu_i=0.4+0.2x_i+0.5x_i^2. 真实模型满足条件方差等于条件均值。比较遗漏二次项的模型和包含二次项的模型:

diag_curvature.png
图:诊断图 A–C。图 B 的弯曲趋势来自均值形式写错;加入 x² 后(图 C)趋势明显减弱,Pearson 统计量除以剩余自由度从 2.4261 降到 0.6898。

图 B 中的弯曲趋势来自均值写错。加入 x2x^2 后,图 C 的趋势明显减弱。 同一数据中,Pearson 统计量除以剩余自由度从 2.42612.4261 降到 0.68980.6898。

先区分均值不充分与额外条件变异
不能仅由 ∑rP2/(n−k)>1\sum r_P^2/(n-k)>1 就断定需要负二项模型。本例的生成分布就是 Poisson;遗漏曲率足以使该比值偏大。 二次模型的比值小于 1 也只是这一份样本的结果,不要求每次模拟恰好为 1。

图 D 使用二次模型的拟合参数及一次固定随机化;它是诊断图,不是精确正态性的证明。

独立性需要另查:一张 Q–Q 图看不见时间关系


emph对应原课件 PDF 第 21、28–31;独立性诊断补充 页 Q–Q 图主要展示残差的边际分布。即使残差的边际直方图近似正态,相邻观测仍可能高度相关。 把残差重新排序不会改变 Q–Q 图,却可能完全改变时间依赖的样子。

第 1 步:保留有实际意义的观测结构

若数据按时间收集,画残差对时间;若来自多个学校、病人或地点,画残差对群组,并保留群组内顺序。 连续很多个同号残差、周期波动、群组均值持续偏高,都值得检查。

第 2 步:用相邻相关描述图中的现象

例如,对于时间顺序下的残差 e1,…,ene_1,\ldots,e_n,一阶样本自相关可写为 ρ̂1=∑i=2n(ei−e‾)(ei−1−e‾)∑i=1n(ei−e‾)2.\hat\rho_1= \frac{\sum_{i=2}^{n}(e_i-\bar e)(e_{i-1}-\bar e)} {\sum_{i=1}^{n}(e_i-\bar e)^2}. 这提供一个描述量;不能把所有残差当成已知均值下的独立同分布样本来机械地解释显著性。 拟合过程本身也会引入残差间依赖。需要检验时,要使用适合数据结构的推断或模拟基准。

第 3 步:把诊断与后续模型选择联系起来

  1. 若趋势随 xx 改变,先检查遗漏项、非线性和交互作用。

  2. 若均值结构合理但波动明显超出模型,检查分布与尺度;计数数据可比较更灵活的方差结构。

  3. 若出现时间或群组相关,考虑与该结构相符的相关模型、随机效应或 GEE。单纯扩大一个共同尺度通常不能描述相关结构本身。

  4. 若由少数观测主导,接着检查杠杆和影响程度,并核对数据来源。

异常值不等于错误值,也不自动等于需要删除 先检查记录、单位、暴露量、群组归属以及模型是否遗漏合理解释。 删除后重新拟合可用于敏感性分析;最终是否排除观测,需要基于数据事实和研究目的说明。

下一部分把“残差很大”“杠杆很高”和“对拟合很有影响”分开,并从 IRLS 推导相应矩阵与 Cook 距离。

从 IRLS 到帽子矩阵:先冻结权重


emph对应原课件 PDF 第 32 页 本节记 k=rank⁡(X)k=\mathop{\mathrm{rank}}(X),即包括截距的可估计回归系数数目。 在一次 IRLS 更新中,先固定当前的 WW 与工作响应 𝝃\boldsymbol\xi, 再求新系数 𝒃\mathbf b: min𝒃(𝝃−X𝒃)𝖳W(𝝃−X𝒃),W=diag⁡(w1,…,wn),wi>0.\min_{\mathbf b}(\boldsymbol\xi-X\mathbf b)^\mathsf T W(\boldsymbol\xi-X\mathbf b),\qquad W=\mathop{\mathrm{diag}}(w_1,\ldots,w_n),\quad w_i>0.

第 1 步:把加权距离变成普通距离

令 A=W1/2XA=W^{1/2}X、𝒛=W1/2𝝃\mathbf z=W^{1/2}\boldsymbol\xi。于是 (𝝃−X𝒃)𝖳W(𝝃−X𝒃)=∥𝒛−A𝒃∥2.(\boldsymbol\xi-X\mathbf b)^\mathsf TW(\boldsymbol\xi-X\mathbf b) =\|\mathbf z-A\mathbf b\|^2. AA 的维数为 n×kn\times k,𝒛\mathbf z 为 n×1n\times1。 这就是对白化后的工作响应做普通最小二乘。

第 2 步:由正规方程得到投影

若 AA 满列秩,则 A𝖳A𝒃̂=A𝖳𝒛,𝒃̂=(A𝖳A)−1A𝖳𝒛.A^\mathsf TA\,\hat{\mathbf b}=A^\mathsf T\mathbf z, \qquad \hat{\mathbf b}=(A^\mathsf TA)^{-1}A^\mathsf T\mathbf z. 左乘 AA 得到 𝒛̂=H𝒛\hat{\mathbf z}=H\mathbf z,其中

GLM 的工作帽子矩阵
H=A(A𝖳A)−1A𝖳=W1/2X(X𝖳WX)−1X𝖳W1/2.H=A(A^\mathsf TA)^{-1}A^\mathsf T =W^{1/2}X(X^\mathsf TWX)^{-1}X^\mathsf TW^{1/2}. HH 把白化工作响应投影到 W1/2XW^{1/2}X 的列空间。

为什么必须强调“工作”和“冻结”? 一般 GLM 中 WW 与 𝝃\boldsymbol\xi 会随拟合改变,且 ξi\xi_i 不是 yiy_i。 因此不能由上式推出 𝝁̂=H𝒚\hat{\boldsymbol\mu}=H\mathbf y。 诊断通常把收敛处的权重代入,研究拟合附近的局部变化。

杠杆值的范围、总和与尺度


emph对应原课件 PDF 第 32–33 页 沿用 H=A(A𝖳A)−1A𝖳H=A(A^\mathsf TA)^{-1}A^\mathsf T。记第 ii 个对角元为 hiih_{ii}。 这里 hiih_{ii} 是杠杆值,与参数关系链中的函数 h(η)=θh(\eta)=\theta 不同。

对称与幂等:投影两次等于一次

因为 A𝖳AA^\mathsf TA 对称,H𝖳=HH^\mathsf T=H。再直接相乘: H2=A(A𝖳A)−1A𝖳A⏟相消(A𝖳A)−1A𝖳=H.H^2=A(A^\mathsf TA)^{-1}\underbrace{A^\mathsf TA}_{\text{相消}} (A^\mathsf TA)^{-1}A^\mathsf T=H. 因而 HH 的特征值只能是 0 或 1。利用迹的循环性质, ∑i=1nhii=tr⁡(H)=tr⁡((A𝖳A)−1A𝖳A)=k.\sum_{i=1}^n h_{ii}=\mathop{\mathrm{tr}}(H) =\mathop{\mathrm{tr}}\bigl((A^\mathsf TA)^{-1}A^\mathsf TA\bigr)=k.

为什么每个杠杆值在 0 与 1 之间?

令 𝒆i\mathbf e_i 为第 ii 个坐标单位向量。由对称幂等性, hii=𝒆i𝖳H𝒆i=∥H𝒆i∥2≥0,1−hii=∥(I−H)𝒆i∥2≥0.h_{ii}=\mathbf e_i^\mathsf TH\mathbf e_i=\|H\mathbf e_i\|^2\ge0, \qquad 1-h_{ii}=\|(I-H)\mathbf e_i\|^2\ge0. 因此 0≤hii≤10\le h_{ii}\le1,且平均杠杆值为 k/nk/n。具体计算可用 hii=wi𝒙i𝖳(X𝖳WX)−1𝒙i.{h_{ii}=w_i\mathbf x_i^\mathsf T(X^\mathsf TWX)^{-1}\mathbf x_i.}

共同尺度为何不影响杠杆?

把权重整体替换为 W/aW/a,则两端各出现 a−1/2a^{-1/2}, 中间的逆矩阵出现 aa: (W/a)1/2X{X𝖳(W/a)X}−1X𝖳(W/a)1/2=H.(W/a)^{1/2}X\{X^\mathsf T(W/a)X\}^{-1}X^\mathsf T(W/a)^{1/2}=H.

如何读一个较大的 hiih_{ii}
它说明该观测在当前加权设计中有较强的拟合能力。 2k/n2k/n 或 3k/n3k/n 可作筛查参考,但不是显著性检验的临界值。 GLM 的杠杆同时受协变量位置与拟合权重影响。

为什么标准化残差要除以 1−hii\sqrt{1-h_{ii}}?


emph对应原课件 PDF 第 25–27,32–33 页 回顾本课约定 wi=1V(μi){g′(μi)}2,ξi=ηi+g′(μi)(Yi−μi),Var⁡(Yi)=aV(μi).w_i=\frac{1}{V(\mu_i)\{g'(\mu_i)\}^2},\qquad \xi_i=\eta_i+g'(\mu_i)(Y_i-\mu_i),\qquad \operatorname{Var}(Y_i)=aV(\mu_i). 在真参数处固定这些量,则 𝔼(ξi)=ηi\mathbb E(\xi_i)=\eta_i、 Var⁡(ξi)=a/wi\operatorname{Var}(\xi_i)=a/w_i。因此白化工作误差的协方差为 aInaI_n。

第 1 步:拟合会吸收一部分随机波动

在冻结权重的线性近似中,白化后的残差是 𝒓W=(I−H)𝒛.\mathbf r_W=(I-H)\mathbf z. 把 Cov⁡(𝒛)≈aIn\operatorname{Cov}(\mathbf z)\approx aI_n 代入,并利用幂等性: Cov⁡(𝒓W)≈(I−H)(aIn)(I−H)𝖳=a(I−H).\operatorname{Cov}(\mathbf r_W)\approx (I-H)(aI_n)(I-H)^\mathsf T=a(I-H). 于是第 ii 个残差的局部方差约为 a(1−hii)a(1-h_{ii})。 高杠杆点的残差容易被拟合过程压小,不能只比较原始大小。

第 2 步:联系 Pearson 残差

在拟合值处,工作残差为 eWi=ξi−η̂ie_{Wi}=\xi_i-\hat\eta_i。注意 wieWi=sign⁡{g′(μ̂i)}yi−μ̂iV(μ̂i)⏟rPi.\sqrt{w_i}\,e_{Wi} =\mathop{\mathrm{sign}}\{g'(\hat\mu_i)\}\, \underbrace{\frac{y_i-\hat\mu_i}{\sqrt{V(\hat\mu_i)}}}_{r_{Pi}}. 递减链接会改变符号,但不改变平方或边际方差。因此通常定义 rPistd=rPiâ(1−hii).{r_{Pi}^{\mathrm{std}} =\frac{r_{Pi}}{\sqrt{\hat a(1-h_{ii})}}.}

这是局部近似,不是精确正态化 实际权重与参数由同一批数据估计,因此上面的协方差推导是局部近似。 标准化 deviance 残差常也除以 â(1−hii)\sqrt{\hat a(1-h_{ii})},其解释更依赖近似。 当 hii=1h_{ii}=1 时分母为零,不能照常计算。离散残差也不会仅靠除以标准差变成正态。

异常值、高杠杆点与影响点:三个问题


emph对应原课件 PDF 第 33 页 对同一个观测,下面三个判断可能得到不同答案。

概念 问的是什么? 常用证据
异常值
(outlier)
给定协变量后,响应是否出乎模型预期? 标准化残差、随机分位数残差
高杠杆点
(leverage)
在当前加权设计中,这一行的位置是否特殊? hiih_{ii},与 k/nk/n 比较
影响点
(influence)
删除或降低该点权重,拟合会改变多少? Cook 距离、删点系数与预测变化

情景 A:远处但贴合趋势

某点的 xix_i 很远,因而杠杆可能高;如果 yiy_i 恰好贴合拟合均值, 残差很小,删点后的系数变化也可能很小。高杠杆不自动等于强影响。

情景 B:中央位置却有很大偏差

某点的协变量位置普通,但响应很大,可能有大残差。 由于杠杆不高,它对整体回归斜率的影响未必最大。

情景 C:特殊位置加上响应偏差

当较大残差与较高杠杆同时出现,删除该点可能明显改变系数。 还要注意:高杠杆点可能把拟合拉向自身,从而掩盖自己的原始残差。

发现可疑点以后,按证据处理
先检查录入、单位、暴露量和观测背景;再比较含该点与删该点的系数、 区间和预测。若观测真实,保留它并报告敏感性通常比直接删除更有解释力。

多个点可以相互掩盖 逐个删点只研究单点影响。几个相似的异常观测可能相互支撑, 使每个点的单独 Cook 距离不大。必要时按有实际意义的组别作敏感性分析。 筛查阈值本身不构成删数据的理由。

删掉一个观测,系数为何出现 1−hii1-h_{ii}?


emph对应原课件 PDF 第 32–33;补充推导 页 在收敛处冻结 W,𝝃W,\boldsymbol\xi,令 B=X𝖳WX,B𝜷̂=X𝖳W𝝃,eWi=ξi−𝒙i𝖳𝜷̂.B=X^\mathsf TWX,\qquad B\hat{\boldsymbol\beta}=X^\mathsf TW\boldsymbol\xi,\qquad e_{Wi}=\xi_i-\mathbf x_i^\mathsf T\hat{\boldsymbol\beta}. 本页 𝜷̂(−i)work\hat{\boldsymbol\beta}_{(-i)}^{\mathrm{work}} 表示删掉第 ii 行后, 保持其余工作量固定的 WLS 解。

第 1 步:从正规方程删去这一行的贡献

(B−wi𝒙i𝒙i𝖳)𝜷̂(−i)work=X𝖳W𝝃−wi𝒙iξi.(B-w_i\mathbf x_i\mathbf x_i^\mathsf T)\hat{\boldsymbol\beta}_{(-i)}^{\mathrm{work}} =X^\mathsf TW\boldsymbol\xi-w_i\mathbf x_i\xi_i. 定义 𝜹i=𝜷̂−𝜷̂(−i)work\boldsymbol\delta_i=\hat{\boldsymbol\beta}-\hat{\boldsymbol\beta}_{(-i)}^{\mathrm{work}}。 将上式与完整正规方程相减,得到 (B−wi𝒙i𝒙i𝖳)𝜹i=wi𝒙i(ξi−𝒙i𝖳𝜷̂)=wi𝒙ieWi.(B-w_i\mathbf x_i\mathbf x_i^\mathsf T)\boldsymbol\delta_i =w_i\mathbf x_i(\xi_i-\mathbf x_i^\mathsf T\hat{\boldsymbol\beta})=w_i\mathbf x_i e_{Wi}.

第 2 步:一个秩一更新怎样求逆?

当 hii=wi𝒙i𝖳B−1𝒙i<1h_{ii}=w_i\mathbf x_i^\mathsf TB^{-1}\mathbf x_i<1 时,Sherman–Morrison 公式给出 (B−wi𝒙i𝒙i𝖳)−1=B−1+wiB−1𝒙i𝒙i𝖳B−11−hii.(B-w_i\mathbf x_i\mathbf x_i^\mathsf T)^{-1} =B^{-1}+ \frac{w_i B^{-1}\mathbf x_i\mathbf x_i^\mathsf TB^{-1}}{1-h_{ii}}. 再右乘 wi𝒙ieWiw_i\mathbf x_i e_{Wi},两项合并: 𝜹i=B−1𝒙iwieWi(1+hii1−hii)=B−1𝒙iwieWi1−hii.\boldsymbol\delta_i =B^{-1}\mathbf x_i w_i e_{Wi} \left(1+\frac{h_{ii}}{1-h_{ii}}\right) ={\frac{B^{-1}\mathbf x_i w_i e_{Wi}}{1-h_{ii}}}.

分母的含义
hiih_{ii} 越接近 1,删除该点后损失的信息越关键,变化可被放大。 这是冻结工作模型中的精确等式;对原 GLM 的真正删点重拟合,它只是近似。 删点后权重和均值也会更新,因此强影响情形应实际重新拟合核对。

由系数变化推导 Cook 距离


emph对应原课件 PDF 第 33;补充尺度与残差约定 页

第 1 步:用信息矩阵衡量“变化多大”

系数有不同单位,不能只比较欧氏距离 ∥𝜹i∥\|\boldsymbol\delta_i\|。 以 B=X𝖳WXB=X^\mathsf TWX 衡量白化拟合值的变化,再除以尺度和系数数目: Ciwork=∥W1/2X𝜹i∥2kâ=𝜹i𝖳B𝜹ikâ.C_i^{\mathrm{work}}= \frac{\|W^{1/2}X\boldsymbol\delta_i\|^2}{k\hat a} =\frac{\boldsymbol\delta_i^\mathsf TB\boldsymbol\delta_i}{k\hat a}.

第 2 步:代入删点公式,逐项消去

𝜹i𝖳B𝜹i=wi2eWi2(1−hii)2𝒙i𝖳B−1BB−1⏟Ik𝒙i=wi2eWi2(1−hii)2hiiwi=wieWi2hii(1−hii)2.\begin{align*} \boldsymbol\delta_i^\mathsf TB\boldsymbol\delta_i &=\frac{w_i^2e_{Wi}^2}{(1-h_{ii})^2} \mathbf x_i^\mathsf TB^{-1}\underbrace{BB^{-1}}_{I_k}\mathbf x_i\\ &=\frac{w_i^2e_{Wi}^2}{(1-h_{ii})^2}\frac{h_{ii}}{w_i} =\frac{w_i e_{Wi}^2h_{ii}}{(1-h_{ii})^2}. \end{align*} 由 wi=1/[V(μ̂i){g′(μ̂i)}2]w_i=1/[V(\hat\mu_i)\{g'(\hat\mu_i)\}^2] 与 eWi=g′(μ̂i)(yi−μ̂i)e_{Wi}=g'(\hat\mu_i)(y_i-\hat\mu_i), wieWi2=(yi−μ̂i)2V(μ̂i)=rPi2.w_i e_{Wi}^2=\frac{(y_i-\hat\mu_i)^2}{V(\hat\mu_i)}=r_{Pi}^2. 平方形式也适用于递减链接。因此原 GLM 的常用近似为

两种等价写法,不能混用残差定义
Ci≈rPi2kâhii(1−hii)2=(rPistd)2khii1−hii.{C_i\approx\frac{r_{Pi}^2}{k\hat a} \frac{h_{ii}}{(1-h_{ii})^2}} \quad=\quad {\frac{(r_{Pi}^{\mathrm{std}})^2}{k} \frac{h_{ii}}{1-h_{ii}}}. 这里 rPistd=rPi/â(1−hii)r_{Pi}^{\mathrm{std}}=r_{Pi}/\sqrt{\hat a(1-h_{ii})}。

原课件第 33 页若沿用第 24 页的 rPr_P 定义,则需采用左式。 R 的 cooks.distance() 使用这一尺度约定。 CiC_i 用于比较影响大小;如 4/n4/n 等筛查线不是严格的检验临界值。

手算:同一个点的四个诊断数字


emph对应原课件 PDF 第 24–25,33;数值例子 页 假设某个 Poisson 回归拟合给出 yi=5,μ̂i=2,hii=0.2,k=2.y_i=5,\qquad \hat\mu_i=2,\qquad h_{ii}=0.2,\qquad k=2. Poisson 的 V(μ)=μV(\mu)=\mu,尺度固定为 a=1a=1。

1. Pearson 残差:按模型方差调整距离

rPi=5−22=32=2.121320,rPi2=92.r_{Pi}=\frac{5-2}{\sqrt2}=\frac3{\sqrt2}=2.121320, \qquad r_{Pi}^2=\frac92.

2. Deviance 残差:把似然损失分配给这个点

di=2{5log52−(5−2)}=3.162907,rDi=+di=1.778456.d_i=2\left\{5\log\frac52-(5-2)\right\}=3.162907, \qquad r_{Di}=+\sqrt{d_i}=1.778456. 正号来自 yi>μ̂iy_i>\hat\mu_i。这两个残差使用不同的距离,所以数值不必相同。

3. 标准化 Pearson 残差:再考虑拟合消耗的信息

rPistd=3/21×(1−0.2)=31.6=2.371708.r_{Pi}^{\mathrm{std}} =\frac{3/\sqrt2}{\sqrt{1\times(1-0.2)}} =\frac3{\sqrt{1.6}}=2.371708. 除以 0.8<1\sqrt{0.8}<1 后,残差被放大,补偿其受到拟合压缩的局部效应。

4. Cook 距离:残差与杠杆一起进入

Ci≈4.520.20.82=0.703125=(2.371708)220.20.8.C_i\approx\frac{4.5}{2}\frac{0.2}{0.8^2} =0.703125 =\frac{(2.371708)^2}{2}\frac{0.2}{0.8}.

最常见的漏项 若把未标准化的 rP=2.121320r_P=2.121320 直接放入只有一个 1−hii1-h_{ii} 的公式, 会误算为 0.56250.5625。先检查残差是否已经除过 a(1−hii)\sqrt{a(1-h_{ii})}, 再选择 Cook 的对应写法。

该点是否值得进一步调查,还要结合其余点的 Cook 距离、样本量、 观测背景和实际删点后的拟合变化判断。

VIF:相关的解释变量为什么放大标准误?


emph对应原课件 PDF 第 34 页 先从有截距的普通线性模型推导。令 𝒙j\mathbf x_j 为第 jj 个解释变量, X−jX_{-j} 包含截距与其余解释变量,P−jP_{-j} 为对它们的投影。

第 1 步:只剩“其他变量解释不了”的部分

把 𝒙j\mathbf x_j 对 X−jX_{-j} 回归,剩余向量为 𝒗j=(I−P−j)𝒙j.\mathbf v_j=(I-P_{-j})\mathbf x_j. 根据分块求逆(或先剔除其余变量的最小二乘), Var⁡(β̂j)=σ2𝒗j𝖳𝒗j.\operatorname{Var}(\hat\beta_j)=\frac{\sigma^2}{\mathbf v_j^\mathsf T\mathbf v_j}.

第 2 步:用辅助回归的 Rj2R_j^2 改写分母

令 Sjj=∑i(xij−x‾j)2S_{jj}=\sum_i(x_{ij}-\bar x_j)^2。辅助回归有截距,因此 Rj2=1−𝒗j𝖳𝒗jSjj,Var⁡(β̂j)=σ2Sjj⏟正交时的基准11−Rj2⏟VIFj.R_j^2=1-\frac{\mathbf v_j^\mathsf T\mathbf v_j}{S_{jj}},\qquad \operatorname{Var}(\hat\beta_j)=\underbrace{\frac{\sigma^2}{S_{jj}}}_{\text{正交时的基准}} \underbrace{\frac1{1-R_j^2}}_{\mathrm{VIF}_j}. 例如 Rj2=0.9R_j^2=0.9,方差放大 10 倍,标准误放大 10\sqrt{10} 倍。 若 Rj2=1R_j^2=1,该列完全由其他列表达,系数不能唯一识别。

搬到 GLM 时,要留意权重与定义

GLM 的局部协方差为 a(X𝖳WX)−1a(X^\mathsf TWX)^{-1},故局部信息取决于加权设计。 可对 𝒙j\mathbf x_j 作含截距的加权辅助回归,得到相应的加权 VIF。 R 的 car::vif() 对 GLM 使用系数相关矩阵;多列项还会报告 GVIF。 不要把它与未加权设计 VIF 当作同一个数。

诊断后的处理
先判断变量是否重复测量同一信息,再考虑有依据地合并、补充数据或正则化。 VIF 的 5 或 10 是经验参考。两两相关很小仍可能存在多列共同的线性依赖; 中心化能改善部分多项式数值问题,却不能消除真实的信息重叠。

把检验、诊断与模型选择接成完整流程


emph对应原课件 PDF 第 35–36 页

搜索策略回答“下一步试哪个模型?”

评价准则回答“这两个模型谁更合适?”

同一数据上的最大似然会偏爱更复杂的嵌套模型;AIC/BIC 用复杂度惩罚作权衡。 嵌套模型的 LR 检验衡量新增限制的证据,但不直接回答预测误差多大。 预测目标还应使用独立测试数据,或把整个选择过程放入交叉验证。

建议按这个顺序分析
  1. 写明响应、协变量、观测单位和目标,确定合理的分布与链接。

  2. 拟合基准模型,检查收敛、参数是否可识别及样本是否一致。

  3. 联合检查均值趋势、分布/离散程度、时间或组内依赖及影响点。

  4. 根据诊断和研究背景提出少量有解释的改进,再比较候选模型。

  5. 报告系数、区间、预测与敏感性;明确哪些结论依赖模型选择。

两个容易忽略的约束

加入 x1x2x_1x_2 时通常保留其主效应,加入 x2x^2 时通常保留 xx, 避免只按单个 pp 值破坏有解释的层级结构。

先选模型,再套普通检验,会低估选择带来的不确定性 搜索重复使用了同一批响应数据。最终模型中的普通 pp 值和区间, 没有自动计入筛选过程。AIC 最小也不证明模型假设成立; 应结合诊断、稳定性和研究问题解释结果。

把影响诊断画出来,再真正删点重拟合


emph对应原课件 PDF 第 33;配套模拟实验 页 下面继续使用 n=60n=60 的 Poisson 二次均值模型,k=3k=3。 左图给出每行的杠杆;右图把常用一步近似与真正删点后得到的系数变化放在一起比较。
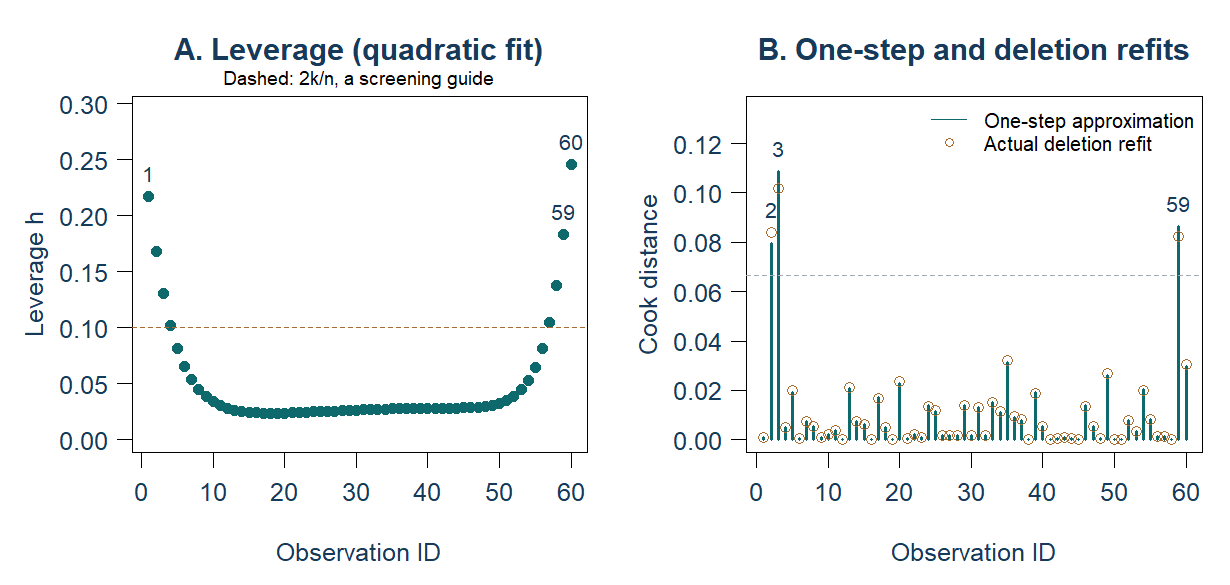
influence.png
图:影响诊断。数据的 x 从小到大排列,边缘观测杠杆较大;虚线为 2k/n = 0.1 的参考线。

先看左图:设计位置怎样影响杠杆

数据的 xx 从小到大排列,边缘观测的杠杆较大。虚线为 2k/n=0.12k/n=0.1, 仅作筛查参考。最右端的观测 60 杠杆最大,但右图最大的 Cook 值来自观测 3。 这正好说明高杠杆与强影响是不同的问题。

再看右图:近似能否反映实际变化?

令真正删点重拟合后的系数为 𝜷̂(−i)\hat{\boldsymbol\beta}_{(-i)}。程序另外计算 Cirefit=1k(𝜷̂(−i)−𝜷̂)𝖳I(𝜷̂)(𝜷̂(−i)−𝜷̂),C_i^{\mathrm{refit}}=\frac1k (\hat{\boldsymbol\beta}_{(-i)}-\hat{\boldsymbol\beta})^\mathsf TI(\hat{\boldsymbol\beta}) (\hat{\boldsymbol\beta}_{(-i)}-\hat{\boldsymbol\beta}), 使用完整模型的信息矩阵作共同标尺。它与冻结工作模型导出的近似通常接近,但不必相同。 观测 3 的 Ciapprox=0.108896C_i^{\mathrm{approx}}=0.108896,实际删点的距离为 0.1017490.101749。 𝜷̂=(0.428802,0.137023,0.489109)𝖳,\hat{\boldsymbol\beta}=(0.428802,\ 0.137023,\ 0.489109)^\mathsf T, 𝜷̂(−3)=(0.417611,0.117785,0.504509)𝖳.\hat{\boldsymbol\beta}_{(-3)}=(0.417611,\ 0.117785,\ 0.504509)^\mathsf T.

怎样写出有内容的诊断结论
可以报告“观测 3 对系数的影响相对较大,但删掉它后,二次项估计仍为正且数值接近”。 进一步判断推断是否稳定,应重算对应区间、检验及感兴趣的预测。 不能只凭 Cook 超过 4/n4/n 就宣告观测错误或自动删去它。

贯穿例子:同一数据完成推断与诊断


emph对应原课件 PDF 第 11–19、24–36;配套模拟例子 页

先知道数据怎样产生,再比较我们拟合的模型

取 n=60n=60,令 xix_i 等距分布于 [−2,2][-2,2],独立生成 Yi∼Poisson⁡(μi),log⁡μi=0.4+0.2xi+0.5xi2.Y_i\sim\operatorname{Poisson}(\mu_i),\qquad \log\mu_i=0.4+0.2x_i+0.5x_i^2. Python 使用固定种子 2026,全部数据另存于 results/curvature_data.csv。这里知道真实模型,是为了教学中能分清 遗漏均值结构与条件分布本身错误。

拟合三个模型:M0:ηi=β0M_0:\eta_i=\beta_0, M1:ηi=β0+β1xiM_1:\eta_i=\beta_0+\beta_1x_i, M2:ηi=β0+β1xi+β2xi2M_2:\eta_i=\beta_0+\beta_1x_i+\beta_2x_i^2。所有模型使用同一批观测。

模型 kk DD AIC BIC XP2/(n−k)X_P^2/(n-k)
截距 M0M_0 1 151.5190 321.2415 323.3358 2.7266
线性 M1M_1 2 136.8552 308.5777 312.7664 2.4261
二次 M2M_2 3 46.1103 219.8328 226.1158 0.6898

把输出读成具体问题的答案

二次模型的估计和标准误分别为 𝜷̂=(0.428802,0.137023,0.489109)𝖳,SE⁡=(0.131484,0.045992,0.051398)𝖳.\hat{\boldsymbol\beta}=(0.428802,\ 0.137023,\ 0.489109)^\mathsf T, \qquad \operatorname{SE}=(0.131484,\ 0.045992,\ 0.051398)^\mathsf T. 检验二次项 H0:β2=0H_0:\beta_2=0,Wald 统计量为 z=0.4891090.051398=9.51619,p≈1.7965×10−21.z=\frac{0.489109}{0.051398}=9.51619, \qquad p\approx1.7965\times10^{-21}. 同一问题的 LR 检验比较 M1⊂M2M_1\subset M_2: G2=D1−D2=90.74490,q=1,p≈1.6344×10−21.G^2=D_1-D_2=90.74490, \qquad q=1,\qquad p\approx1.6344\times10^{-21}. 两个统计量不完全相同,但在此样本中给出一致的强证据。偏差解释比例为 1−D2/D0=0.6956801-D_2/D_0=0.695680。它不是响应方差被解释的百分比。

从数值回到诊断
线性模型的 Pearson 比值约为 2.43,加入二次项后降为 0.69。 本例真实条件分布一直是 Poisson:较大的初始比值可以来自遗漏曲率。 一次样本的 0.69 也不能单独证明总体欠离散。应结合均值结构、残差图与数据来源判断。

本例近似 Cook 距离最大的是第 3 个观测,约为 0.108896; 删除它重新拟合所得的信息距离约为 0.101749。差异显示一步近似与完整重拟合的区别。

Python:把公式直接翻译成数值


emph对应原课件 PDF 第 11–19、24–34;配套程序 页

在项目目录运行 python glm_diagnostics.py,即可重建数据、模型表和逐点诊断。 程序只需要 NumPy 与标准库;以下片段也能在同一目录独立运行。

import numpy as np
from glm_diagnostics import (make_curvature_data,
    fit_poisson, wald_test, compare_models, diagnostics)

x, y, mu_true = make_curvature_data()
X1 = np.column_stack([np.ones(len(x)), x])
X2 = np.column_stack([np.ones(len(x)), x, x*x])
m1 = fit_poisson(X1, y)
m2 = fit_poisson(X2, y)
print("beta, SE:", m2["beta"], m2["se"])
print("Wald:", wald_test(m2, [[0, 0, 1]]))
print("LRT:", compare_models(m1, m2))

d = diagnostics(m2, seed=2606)
print("sum rD^2, D:", sum(d["rD"]**2), m2["deviance"])
print("sum h, k:", sum(d["h"]), m2["k"])
print("largest Cook id:", np.argmax(d["cook_approx"])+1)
assert np.allclose(sum(d["rD"]**2), m2["deviance"])
assert np.allclose(sum(d["h"]), m2["k"])

每一行对应哪个数学对象?

X2 的三列依次对应截距、xx、x2x^2。因此 [[0,0,1]] 就是选择 β2\beta_2 的限制矩阵 RR。若要联合检验两个斜率,改用 [[0,1,0],[0,0,1]],而非逐个检验后数一数有几个显著。

m2["covariance"] 为 Cov̂(𝜷̂)\hat{\operatorname{Cov}}(\hat{\boldsymbol\beta}), m2["I"] 为信息矩阵;程序先从协方差构造 RΣ̂R𝖳R\hat{\Sigma} R^\mathsf T, 再解线性方程计算 Wald 二次型。

先打开哪些结果?

model_comparison.csv 给出上页的模型比较表; quadratic_diagnostics.csv 每行对应一个观测; case_deletion.csv 对照一步 Cook 近似与实际删点重拟合。 均位于 results/ 下,完整接口说明见 README_CODE.md。

程序的范围 本实现聚焦独立的 Poisson-log 数据,固定 a=1a=1,要求显式截距与满列秩。 它不实现 offset、缺失值处理或通用分离检测。随机化残差的种子固定只为复现图形, 不能使代入估计参数后的残差变成精确独立的标准正态样本。

R:用官方 GLM 实现复核同一数据


emph对应原课件 PDF 第 25、33;配套程序 页

先运行 Python 程序生成 CSV,再在项目目录执行 Rscript --vanilla companion.R。该脚本只需 base R, 并将数值与诊断图分别写入 results_r/ 与 figures/。 下面是可以直接复制到 R 中的核心部分。

d <- read.csv("results/curvature_data.csv")
m1 <- glm(y ~ x, data=d, family=poisson(link="log"))
m2 <- glm(y ~ x + I(x^2), data=d,
          family=poisson(link="log"))
coef(summary(m2))
anova(m1, m2, test="Chisq")
AIC(m1, m2)
BIC(m1, m2)

b <- coef(m2)[-1]
S <- vcov(m2)[-1, -1, drop=FALSE]
W <- as.numeric(t(b) %*% solve(S, b))
c(Wald=W, p=pchisq(W, df=2, lower.tail=FALSE))

rP <- residuals(m2, type="pearson")
rD <- residuals(m2, type="deviance")
h <- hatvalues(m2)
c(sum_rD2=sum(rD^2), deviance=deviance(m2))
c(sum_h=sum(h), k=m2$rank)
all.equal(cooks.distance(m2),
          rP^2/m2$rank * h/(1-h)^2)

对照输出,而不是只记函数名

coef(summary(m2)) 同时给出系数、标准误、Wald zz 与双侧 pp 值。 vcov(m2)[-1,-1] 是删除截距对应行列后的协方差子矩阵。 本例联合 Wald 为 107.753505,自由度为 2。

anova(m1,m2,test="Chisq") 对应两个嵌套 Poisson 模型的偏差差检验。 本例固定 a=1a=1,不能把其调用机械搬到所有未知尺度的 GLM 上。 rstandard(m2,type="pearson") 返回的标准化 Pearson 残差已经包含 1−hii\sqrt{1-h_{ii}} 的修正。

Python 与 R 应当在哪里一致?
同一数据、同一模型和充分收敛时,两边应得到相同的系数、标准误、偏差、AIC/BIC、 杠杆与 Cook 距离,允许浮点误差。随机化分位数残差使用了各自的随机数发生器与种子, 其逐点数值无需一致;其 CDF 区间及统计定义应一致。

练习 I:推断与残差

1. 单项与联合 Wald:先取哪个矩阵?

模型含截距与两个斜率,已知 𝜷̂=(1,0.4,−0.2)𝖳,Σ̂=(0.250.0500.050.040.0100.010.09).\hat{\boldsymbol\beta}=(1,0.4,-0.2)^\mathsf T,\qquad \hat{\Sigma}= \begin{pmatrix} 0.25&0.05&0\\ 0.05&0.04&0.01\\ 0&0.01&0.09 \end{pmatrix}. (a) 检验 H0:β1=0H_0:\beta_1=0,求 Wald zz、双侧 pp 值及 95% 区间。 (b) 检验 H0:(β1,β2)=(0,0)H_0:(\beta_1,\beta_2)=(0,0),求联合 Wald、自由度和结论。 (c) 为什么不能先求 Σ̂−1\hat{\Sigma}^{-1},再直接取其右下角二阶子矩阵?

2. LR、AIC 与 BIC 可以给出不同选择吗?

同一组 n=100n=100 个 Poisson 观测上,两个嵌套模型的最大化对数似然分别为 ℓ0=−80\ell_0=-80、ℓ1=−77\ell_1=-77,参数个数为 k0=2k_0=2、k1=4k_1=4。 求 LR 统计量、自由度、pp 值、两模型的 AIC 与 BIC。 解释为何 LR 的 5% 结论、AIC 与 BIC 不必一致。

3. 两个观测,逐项算出两类残差

Poisson 模型中 𝒚=(0,2)𝖳\mathbf y=(0,2)^\mathsf T、𝝁̂=(1,1)𝖳\hat{\boldsymbol\mu}=(1,1)^\mathsf T,a=1a=1。 求每个观测的 di,rDi,rPid_i,r_{Di},r_{Pi},并计算 DD 与 XP2X_P^2。 验证 D=∑irDi2D=\sum_i r_{Di}^2,并解释为什么 DD 不必等于 XP2X_P^2。

4. Bernoulli 为什么要随机化?

已知真实成功概率 p=1/4p=1/4。对 y=0y=0 与 y=1y=1,写出随机化分位数残差的 均匀抽样区间。若抽样比例均取 v=1/2v=1/2,计算 uu 与 Φ−1(u)\Phi^{-1}(u)。 解释直接使用 Φ−1{F(y)}\Phi^{-1}\{F(y)\} 有什么问题,并说明这里的精确正态结论依赖什么。

作答顺序 先写假设或定义,再代入数值。第 1 题的 β1\beta_1 是第一个斜率; 第 2 题的 kk 均包括截距;第 3 题在 yi=0y_i=0 时用极限约定 0log⁡0=00\log0=0。

练习 II:杠杆、影响与模型判断

5. 手算一个 GLM 工作 hat 矩阵

令 X=(1,1,1)𝖳X=(1,1,1)^\mathsf T,某一步工作权重为 W=diag⁡(1,2,3)W=\mathop{\mathrm{diag}}(1,2,3)。求 H=W1/2X(X𝖳WX)−1X𝖳W1/2,H=W^{1/2}X(X^\mathsf TWX)^{-1}X^\mathsf TW^{1/2}, 写出三个杠杆,验证 tr⁡(H)=k\mathop{\mathrm{tr}}(H)=k 与 H2=HH^2=H。 若将 WW 整体乘以 5,HH 是否改变?这里的投影作用于 𝒚\mathbf y 还是工作量?

6. Cook 距离到底有几个 1−hii1-h_{ii}?

某 GLM 有 k=3k=3,固定公共尺度 a=2a=2。一个观测的未含尺度修正的 Pearson 残差为 rPi=2r_{Pi}=2,杠杆为 hii=1/4h_{ii}=1/4。 分别计算标准化 Pearson 残差与近似 Cook 距离,并用两种等价写法核对。 若只把杠杆改为 3/43/4,Cook 距离变为多少?这些结果是否足够支持删点?

7. VIF 是什么比值?

把某一解释变量对其他解释变量及截距做普通最小二乘回归,得到 Rj2=0.9R_j^2=0.9。 计算普通设计 VIF 与标准误膨胀因子。 说明该 VIF 在同方差线性模型中的精确解释,以及为什么不能直接作为所有 GLM 系数方差膨胀的精确倍数。高 VIF 本身能否证明响应分布选错?

8. 将诊断证据串成一个分析结论

一份 Poisson-log 分析中,线性模型的残差对 xx 呈 U 形, Pearson 比值为 2.4。加入 x2x^2 后 U 形大幅减弱,AIC 降低, Pearson 比值变为 0.7。另一个 Bernoulli 模型的偏差残差 Q–Q 图明显弯曲。 请判断并解释以下说法:

  1. “第一份数据的真实条件方差一定大于条件均值,应立即改成负二项。”

  2. “二次模型比值小于 1,已证明数据欠离散。”

  3. “Bernoulli 偏差残差不正态,已证明 logistic 模型错误。”

  4. “找出 Cook 最大的点,删除后只报告更显著的结果即可。”

最后给出一个合理的后续检查顺序,并说明同一数据上反复筛选后, 直接把最终模型的普通 pp 值当作事先指定检验有什么问题。

练习答案 I:Wald 与模型比较

第 1 题:协方差先选子块,再求逆

SE⁡(β̂1)=0.04=0.2\operatorname{SE}(\hat\beta_1)=\sqrt{0.04}=0.2,所以 z=0.4/0.2=2,p=2{1−Φ(2)}=0.04550.z=0.4/0.2=2,\qquad p=2\{1-\Phi(2)\}=0.04550. 按 5% 水平拒绝 H0H_0。使用 1.961.96 的 95% 区间为 0.4±1.96(0.2)=(0.008,0.792)0.4\pm1.96(0.2)=(0.008,0.792)。

联合检验先取 𝜷̂*=(0.4−0.2),S=(.04.01.01.09),S−1=1.0035(.09−.01−.01.04).\hat{\boldsymbol\beta}_* =\binom{0.4}{-0.2},\qquad S=\begin{pmatrix}.04&.01\\.01&.09\end{pmatrix},\qquad S^{-1}=\frac1{.0035}\begin{pmatrix}.09&-.01\\-.01&.04\end{pmatrix}. 于是 W=𝜷̂*𝖳S−1𝜷̂*=.09(.4)2−2(.01)(.4)(−.2)+.04(−.2)2.0035=5.028571.W=\hat{\boldsymbol\beta}_*^\mathsf TS^{-1}\hat{\boldsymbol\beta}_* =\frac{.09(.4)^2-2(.01)(.4)(-.2)+.04(-.2)^2}{.0035} =5.028571. 自由度为 2,p=Pr⁡(χ22≥W)=e−W/2=0.08092p=\Pr(\chi_2^2\ge W)=e^{-W/2}=0.08092,5% 水平不拒绝。 这与单项结论并不矛盾:检验的限制数目、协方差和参照分布不同。

若把 Σ̂−1\hat{\Sigma}^{-1} 的右下角子块直接使用,会得到错误的二次型 6.615385。矩阵求逆通常不与取子块交换;完整逆矩阵的该子块涉及截距与斜率的关联, 不是斜率边际协方差的逆。

第 2 题:同一似然改善,不同复杂度惩罚

G2=2{−77−(−80)}=6,q=4−2=2,p=e−3=0.049787.G^2=2\{-77-(-80)\}=6,\qquad q=4-2=2, \qquad p=e^{-3}=0.049787.

简单模型 M0M_0 复杂模型 M1M_1
AIC 160+2(2)=164160+2(2)=164 154+2(4)=162154+2(4)=162
BIC 160+2log⁡100=169.2103160+2\log100=169.2103 154+4log⁡100=172.4207154+4\log100=172.4207

LR 在 5% 水平刚好拒绝简单模型;AIC 选择复杂模型,BIC 选择简单模型。 加入 qq 个参数时,AIC 要求 G2>2qG^2>2q,BIC 要求 G2>qlog⁡nG^2>q\log n。 本题的 6 位于 4 和 9.2103 之间。信息准则不是预先固定显著性水平的假设检验, 它们也不单独证明所选模型的所有假设正确。

练习答案 II:残差、随机化与投影

第 3 题:平方和相同不等于每类残差相同

Poisson 单位偏差为 d(y,μ)=2{ylog⁡(y/μ)−(y−μ)}d(y,\mu)=2\{y\log(y/\mu)-(y-\mu)\}。 第一个观测 y=0,μ=1y=0,\mu=1,故 d1=2d_1=2、rD1=−2r_{D1}=-\sqrt2、rP1=−1r_{P1}=-1。 第二个观测 y=2,μ=1y=2,\mu=1,故 d2=4log⁡2−2=0.772589,rD2=4log⁡2−2=0.878970,rP2=1.d_2=4\log2-2=0.772589,\qquad r_{D2}=\sqrt{4\log2-2}=0.878970,\qquad r_{P2}=1. 因此 D=2+(4log⁡2−2)=4log⁡2=2.772589D=2+(4\log2-2)=4\log2=2.772589,而 XP2=(−1)2+12=2X_P^2=(-1)^2+1^2=2。 偏差用完整似然差,Pearson 用均值方差尺度上的平方距离;前者在接近拟合均值时 才由二阶展开近似后者。

第 4 题:把离散跳跃填成连续区间

F(−1)=0,F(0)=3/4,F(1)=1F(-1)=0,F(0)=3/4,F(1)=1,故 y=0:U∼Unif⁡(0,3/4),y=1:U∼Unif⁡(3/4,1).y=0:\quad U\sim\operatorname{Unif}(0,3/4),\qquad y=1:\quad U\sim\operatorname{Unif}(3/4,1). 取区间内比例 v=1/2v=1/2,两种情形得到 U=3/8,rQ=−0.318639;U=7/8,rQ=1.150349.U=3/8,\quad r_Q=-0.318639;\qquad U=7/8,\quad r_Q=1.150349. 直接代入 F(Y)F(Y) 只有两个可能值,且 Y=1Y=1 时 Φ−1(1)=+∞\Phi^{-1}(1)=+\infty。 随机化后,在前一区间的混合密度为 (3/4)/(3/4)=1(3/4)/(3/4)=1,后一区间为 (1/4)/(1/4)=1(1/4)/(1/4)=1,于是整个 (0,1)(0,1) 上均匀,逆正态变换才给出标准正态。 此精确结论使用已知的真实 pp;从同一数据估计 pp 后不能照搬精确独立结论。

第 5 题:加权空间中的秩一投影

令 z=(1,2,3)𝖳z=(1,\sqrt2,\sqrt3)^\mathsf T,则 z𝖳z=6z^\mathsf Tz=6, H=zz𝖳6=16(123226363).H=\frac{zz^\mathsf T}{6} =\frac16\begin{pmatrix}1&\sqrt2&\sqrt3\\ \sqrt2&2&\sqrt6\\\sqrt3&\sqrt6&3\end{pmatrix}. 杠杆为 (1/6,1/3,1/2)(1/6,1/3,1/2),和为 1=k1=k。又 H2=z(z𝖳z)z𝖳/36=zz𝖳/6=HH^2=z(z^\mathsf Tz)z^\mathsf T/36=zz^\mathsf T/6=H。 WW 乘以 5 后,两侧各出现 5\sqrt5,中间逆矩阵出现 1/51/5,互相抵消。 它把加权工作响应 W1/2𝝃W^{1/2}\boldsymbol\xi 投影到 𝒞(W1/2X)\mathcal C(W^{1/2}X),一般不能写成 𝝁̂=H𝒚\hat{\boldsymbol\mu}=H\mathbf y。

练习答案 III:尺度、影响与诊断解释

第 6 题:把残差的定义一起带入公式

标准化 Pearson 残差与 Cook 距离分别为 rPistd=22(3/4)=1.632993,Ci=42⋅31/4(3/4)2=827=0.296296.r_{Pi}^{\mathrm{std}}=\frac{2}{\sqrt{2(3/4)}}=1.632993, \qquad C_i=\frac{4}{2\cdot3}\frac{1/4}{(3/4)^2} =\frac8{27}=0.296296. 另一写法也给出 Ci=(rPistd)2{hii/(1−hii)}/k=(8/3)(1/3)/3=8/27C_i=(r_{Pi}^{\mathrm{std}})^2\{h_{ii}/(1-h_{ii})\}/k =(8/3)(1/3)/3=8/27。若 hii=3/4h_{ii}=3/4,则 Ci={4/(2⋅3)}(3/4)/(1/4)2=8C_i=\{4/(2\cdot3)\}(3/4)/(1/4)^2=8。 相同残差在高杠杆处可能造成更大的系数改变。应检查观测真实性、设计位置和实际删点敏感性, 不能仅凭阈值自动删除。

第 7 题:设计共线性与方差尺度是两回事

VIF⁡j=11−Rj2=10,VIF⁡j=10=3.162278.\operatorname{VIF}_j=\frac1{1-R_j^2}=10, \qquad \sqrt{\operatorname{VIF}_j}=\sqrt{10}=3.162278. 同方差线性模型中,在保持误差方差和该列总离差平方和不变的比较下, 它相对于该列与其余解释变量正交的设计给出方差放大倍数;标准误放大其平方根。 GLM 的协方差涉及 X𝖳WXX^\mathsf TWX,因此还取决于拟合均值与工作权重, 普通未加权 VIF 不是通用的精确系数方差倍数。 VIF 只描述解释变量之间的线性关系,不能证明响应分布选错。

第 8 题:四句话都把线索说成了定论

(a) 不成立。遗漏 x2x^2 会使条件均值系统偏离;先检查和改善均值结构,再考虑 是否仍需更灵活的方差模型。(b) 不成立。离散比值有抽样波动,也受拟合与模型结构影响。 (c) 不成立。Bernoulli 残差本来就高度离散,逐点偏差残差不必接近正态。 (d) 不合理。最大 Cook 指出值得检查的观测,分析者应说明删除理由并报告敏感性, 不能只保留使结果更显著的版本。

合理顺序可以是:核对数据及独立性背景,检查均值与链接的结构, 再查看残差分布、离散程度、杠杆与实际删点敏感性;对最终候选模型比较适当的准则, 必要时使用独立验证数据或重抽样评估预测表现。

选模型和做推断之间还隔着一步
同一数据上反复尝试变换、交互项、变量组合,再挑最小 pp 值,会引入选择偏差。 最终模型的普通标准误与 pp 值没有自动计入整个搜索过程。 应说明探索过程,尽量区分探索与预先指定的验证,并保留符合问题背景的模型层级。

与课件的对应、公式约定与参考资料

本讲义采用的阅读修正

原 PDF 阅读时需要补充的条件或记号
第 8 页 子参数向量的协方差取自 I−1I^{-1},不是 II;先求完整协方差再取子矩阵。
第 16 页 残差 D/aD/a 对 χn−k2\chi^2_{n-k} 的近似需要足够组内信息等条件;个体 Bernoulli 不能无条件套用。
第 18 页 AIC/BIC 的参数个数包含实际估计的尺度或形状参数;固定尺度例子才直接等于回归系数数。
第 26 页 离散响应的分位数残差需随机化;精确正态针对真分布已知的变换,拟合后是近似。
第 32 页 帽子矩阵投影的是冻结权重后的白化工作响应;通常不能写成 μ̂=Hy\hat\mu=Hy。
第 33 页 未标准化 Pearson 残差对应 Ci=rPi2hii/[kâ(1−hii)2]C_i=r_{Pi}^2h_{ii}/[k\hat a(1-h_{ii})^2];换用标准化残差才可少写一个 1−hii1-h_{ii}。
第 34 页 普通设计 VIF 与 GLM 基于系数相关矩阵的 VIF/GVIF 不是同一约定。

资料与软件核对来源

主体依据指定的 MTH303 Chapter 6: Generalized Linear Models – Inference, Goodness-of-fit and Diagnostic,37 页课件。每节顶部标注所对应的原 PDF 页码; 推导、手算数据、代码实验和练习均为补充讲解。

  1. R 官方 summary.glm 文档:尺度、协方差及 z/tz/t 输出约定。

  2. R 官方 anova.glm 文档:同一数据上的嵌套模型与偏差比较。

  3. R 官方 AIC 文档及 logLik 文档:可比似然与参数计数。

  4. R 官方 删除诊断文档及 实现源码:标准化残差与 Cook 距离。

  5. Dunn, P. K. and Smyth, G. K. (1996), Randomized quantile residuals, Journal of Computational and Graphical Statistics, 5(3), 236–244。

  6. Fox 与 Weisberg 的 car 包 VIF 文档:系数相关矩阵与 GVIF 约定。

可复现文件

主文件 main.tex 调用 sections/ 下的分节源码;图保存在 figures/。 Python 只需 NumPy,R 实验只用基础包。results/ 和 results_r/ 保存拟合、逐点诊断和独立对照结果;运行方式与教学范围见配套 README。

This page was generated by DeepSeek 4.1 Flash from the course source; derivations and numbers are reproduced verbatim.

本页由 DeepSeek 4.1 Flash 依据课程讲义生成,推导与数值均按原讲义保留。